GPT-6 Sol e Luna: benchmark, prezzi e alternative
Performance su coding e automazioni, costi API e confronto con Astra, Claude Fable 5 e Claude Opus 5
Entra nell'analisi
Risposta breve
Scegli GPT-6 Sol per coding, agenti e lavoro complesso quando Astra costa troppo. Usa GPT-6 Luna per estrazione, classificazione e automazioni ripetute in cui puoi verificare facilmente il risultato. Nei benchmark OpenAI, Sol è vicino a Claude Fable 5 su DeepSWE e davanti ad Astra e Opus 5 su AutomationBench, pur costando molto meno a parità di token.
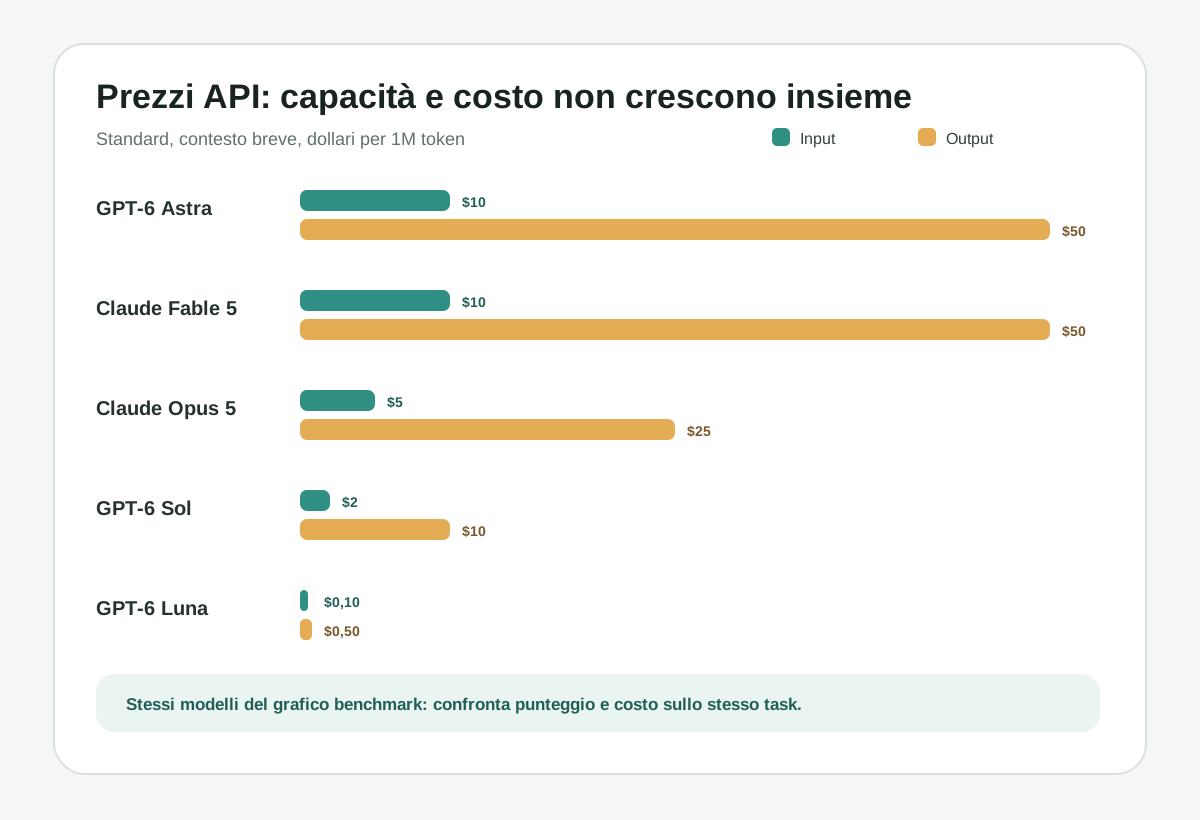
- GPT-6 Sol costa $2 input e $10 output per 1M token in modalità Standard e contesto breve.
- GPT-6 Luna costa $0,10 input e $0,50 output per 1M token.
- Sol e Luna hanno 1,05M token di contesto e output massimo di 128K.
- Oltre 272K token di input, OpenAI applica la fascia long context all'intera richiesta.
- I benchmark di lancio sono del vendor e vanno verificati sul proprio harness.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Modello | Quando sceglierlo |
|---|---|---|
| GPT-6 Astra | Massima capacità della famiglia GPT-6, a $10 input e $50 output per 1M token. | Usalo per i task più difficili, con computer use o molte decisioni concatenate, quando ridurre errori e supervisione vale più del costo per token. |
| GPT-6 Sol | Modello da $2/$10 orientato a coding complesso e workflow agentici. | È il punto di partenza più equilibrato per Codex, automazioni professionali e API che devono ragionare senza pagare sempre Astra. |
| GPT-6 Luna | Modello da $0,10/$0,50 per attività focalizzate e ad alto volume. | Conviene per classificazione, estrazione, trasformazioni e passaggi agentici delimitati. Serve una verifica forte quando un errore può propagarsi. |
| Claude Fable 5 | Alternativa da $10/$50, al 69,9% su DeepSWE nella tabella OpenAI. | Nel benchmark supera Sol di 1,1 punti, ma nel carico economico mostrato costa cinque volte tanto. Il margine va verificato sul proprio repository. |
| Claude Opus 5 | Alternativa da $5/$25, al 26,9% su AutomationBench nella tabella OpenAI. | Sol segna 33,2% e costa meno della metà nel carico mostrato. Effort diversi e dati del vendor impediscono però una conclusione universale. |
Applicazione
Quanto cambia il costo
Le stime usano il listino Standard verificato il 23 settembre 2026 e isolano input e output. Non includono strumenti, container, retry, cache write o maggiorazioni regionali.
Task professionale
100K input · 20K output
- Carico di esempio
- Sol: $0,40
- Costo indicativo
- Fable 5: $2,00
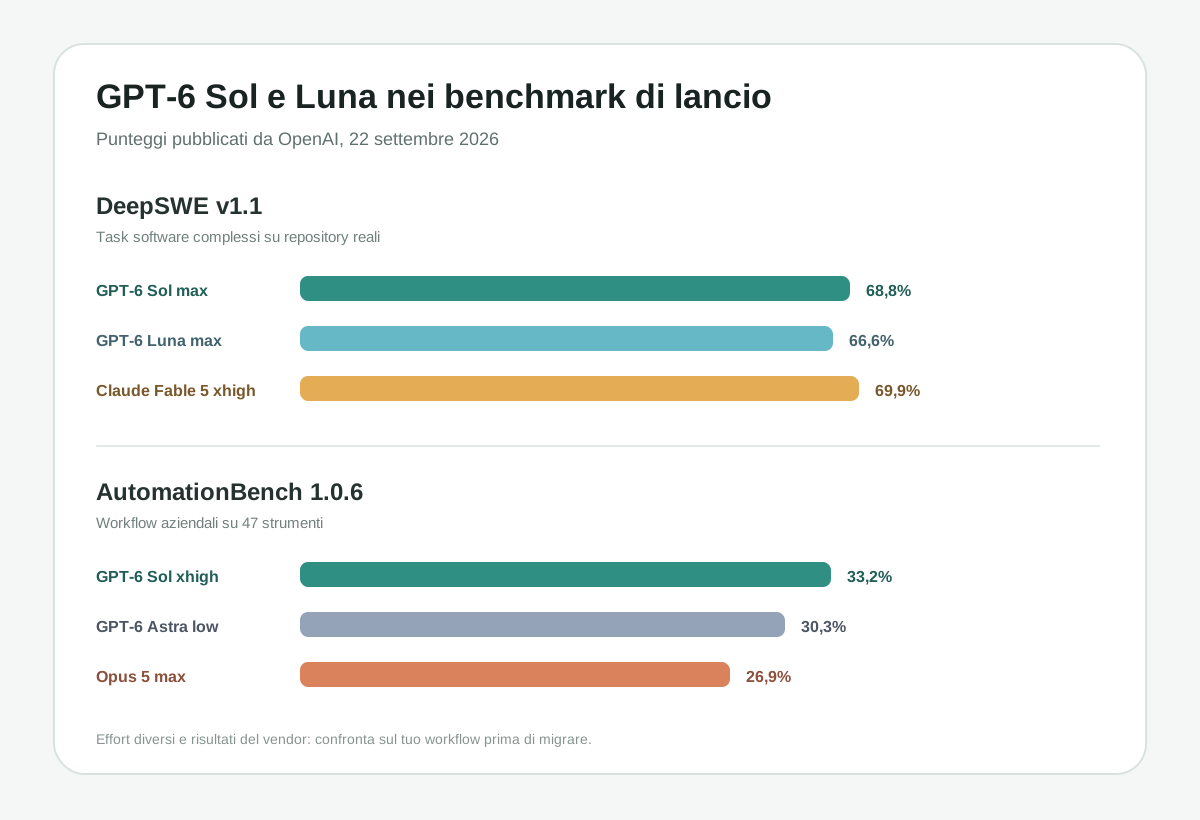
Su DeepSWE i punteggi dichiarati sono 68,8% per Sol e 69,9% per Fable 5. A parità di token, Sol costa un quinto in questo esempio.
Pipeline ad alto volume
200K input · 40K output
- Carico di esempio
- Luna: $0,04
- Costo indicativo
- Sol: $0,80
Luna costa venti volte meno, ma il risparmio scompare se il task richiede molti tentativi o una review manuale costosa.
Automazione complessa
100K input · 20K output
- Carico di esempio
- Sol: $0,40
- Costo indicativo
- Astra: $2,00
Su AutomationBench Sol xhigh segna 33,2% e Astra low 30,3% nella tabella OpenAI. In questo carico Sol costa un quinto, ma effort e affidabilità vanno verificati sul proprio flusso.
Come leggere performance, prezzi e alternative
Sol e Luna coprono due esigenze diverse: Sol riduce il costo del ragionamento complesso rispetto ad Astra, mentre Luna punta sui volumi elevati. I grafici mantengono la stessa coorte del lancio OpenAI, con Claude Fable 5 e Opus 5: questo permette di collegare prezzi e punteggi, ma non sostituisce un confronto con le versioni più recenti. Terra resta un modello GPT-5.6.
- Astra è l'escalation OpenAI per i problemi più difficili.
- Sol bilancia capacità, agenti e costo.
- Luna privilegia volume ed efficienza.
- Per modelli usciti dopo il benchmark, usa eval separati invece di mescolare coorti diverse.
- Dal 29 settembre 2026 esiste GPT-6.1 Sol, un aggiornamento di Sol con lo stesso listino base: il confronto con Astra è nell'approfondimento dedicato.
Quando partire da GPT-6 Sol
Sol è la scelta più sensata quando il task richiede ragionamento, strumenti e più passaggi, ma non giustifica il listino di Astra. OpenAI lo orienta a coding e workflow agentici; il vantaggio pratico è poter aumentare effort o ripetere un task senza moltiplicare subito il budget per cinque.
- Coding agentico con test, diff e strumenti.
- Automazioni professionali tra più applicazioni.
- Analisi di file e documenti con output verificabile.
- Workflow API in cui Luna fallisce troppo spesso e Astra è sovradimensionato.
Quando Luna fa davvero risparmiare
Luna costa un ventesimo di Sol a parità di token Standard. Questo divario conta nei volumi elevati, ma solo se la richiesta è delimitata e il risultato si controlla in modo economico. Per attività ambigue o con conseguenze difficili da correggere, un modello più capace può costare meno sul risultato finale.
- Classificazione con categorie note e test automatici.
- Estrazione di campi da documenti regolari.
- Riscritture e trasformazioni con formato strutturato.
- Subtask semplici dentro un agente che usa Sol o Astra per la verifica finale.
Cosa dicono i benchmark, e cosa non dicono
Nel lancio OpenAI, Sol ottiene 68,8% su DeepSWE v1.1 e Luna 66,6%, mentre Claude Fable 5 arriva al 69,9% nella configurazione riportata da OpenAI, non da Anthropic. Su AutomationBench, Sol xhigh segna 33,2%. Sono risultati utili per scegliere cosa testare, ma provengono dal vendor e confrontano livelli di effort diversi.
- DeepSWE misura task software complessi su repository reali.
- AutomationBench misura workflow tra applicazioni aziendali.
- Un punto percentuale non conta quanto test, harness e costo per task accettato.
- Per il tuo eval usa prompt, strumenti, limiti e criteri uguali.
Prezzi, cache e soglia dei 272K token
Il listino Standard parte da $2/$10 per Sol e $0,10/$0,50 per Luna. Le letture dalla cache costano il 10% dell'input normale. Quando una richiesta supera 272K token di input, OpenAI applica il prezzo long context all'intera richiesta: $4/$15 per Sol e $0,20/$0,75 per Luna.
- La cache read costa $0,20 per Sol e $0,01 per Luna nel contesto breve.
- Le cache write hanno un prezzo separato.
- Batch e Flex applicano sconti, mentre Fast mode costa di più.
- La residenza dati UE è disponibile solo con elaborazione Standard.
Quando mantenere GPT-5.6 Terra
Non serve sostituire Terra solo perché Sol appartiene a una generazione nuova. Se un'applicazione ha prompt stabili, eval superati e costi prevedibili, una migrazione introduce lavoro e rischio. Sol diventa il candidato naturale quando inizi un progetto, quando Terra richiede troppi retry o quando vuoi ridurre il costo output da $12 a $10.
- Mantieni Terra finché rispetta la soglia di qualità e affidabilità.
- Confronta Terra e Sol sugli stessi casi prima di cambiare il model ID.
- Misura variazioni di stile, tool calling e lunghezza dell'output.
- Prepara un rollback se il modello alimenta processi di produzione.
Una regola pratica per il routing
Usa Luna per il lavoro ripetibile, Sol per il lavoro complesso e Astra come escalation. Mantieni Terra soltanto dove gli eval dimostrano che cambiare non porta un vantaggio. Questa gerarchia riduce il costo senza affidare ogni passaggio al modello meno caro o ogni richiesta a quello più potente.
- Luna: task delimitati, volume alto, verifica automatica.
- Sol: coding, agenti, analisi e strumenti.
- Astra: problemi difficili e costosi da correggere.
- Terra: workflow GPT-5.6 già validati.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Esiste GPT-6 Terra?
No. La famiglia GPT-6 ufficiale comprende Astra, Sol e Luna. Terra resta disponibile come GPT-5.6 Terra; OpenAI non ha pubblicato un model ID, un prezzo o una scheda per GPT-6 Terra.
Qual è la differenza tra GPT-6 Sol e Luna?
Sol è più adatto a coding, agenti e task complessi. Luna privilegia costo e volume: conviene per attività delimitate e facilmente verificabili. Entrambi supportano contesto da 1,05M token e gli strumenti della Responses API.
GPT-6 Sol sostituisce GPT-5.6 Terra?
Non automaticamente, ma è il primo modello da provare per un nuovo progetto: costa $2 input come Terra e $10 output invece di $12. Mantieni Terra se i tuoi eval mostrano risultati più stabili o se la migrazione non ripaga il lavoro richiesto.
GPT-6 Sol e Luna sono disponibili in ChatGPT?
Al lancio sono disponibili in ChatGPT Work e Codex per Plus, Pro, Business, Enterprise ed Edu, ma non nella chat standard. Gli utenti Free e Go possono provare Luna nell'app desktop. Entrambi sono disponibili via API.
Quale modello costa meno per un coding agent?
Luna ha il listino più basso, ma Sol è spesso il confronto più utile per coding complesso. Misura costo per task completato, inclusi retry e review: il modello con meno token può costare di più se fallisce più spesso.
Prossime letture