Gemini Carbon batte Claude e GPT? Cosa cambia davvero
Il nuovo modello di punta Google guida l'indice generale, ma non puoi ancora usarlo: dove il primato regge contro Opus 5.5, GPT-6 Astra e Fable 5.1, dove no e cosa scegliere nel frattempo
Entra nell'analisi
Risposta breve
In parte. Carbon è primo di misura nella media dei test e inventa molte meno risposte di Opus e Astra, ma non supera Claude nel coding agentico e oggi non è accessibile. Per documenti lunghi, automazioni o ricerca, provalo appena arriva nel tuo account. Per Claude Code con Opus su un repository, resta dove sei. Per Google adesso, usa Argon.
- Carbon è aperto solo a difensori cyber selezionati: Google non dà una data per sviluppatori, aziende e app Gemini.
- Nel coding agentico la misura indipendente di Artificial Analysis mette ancora Claude Code con Opus 5.5 davanti a Carbon con Antigravity CLI.
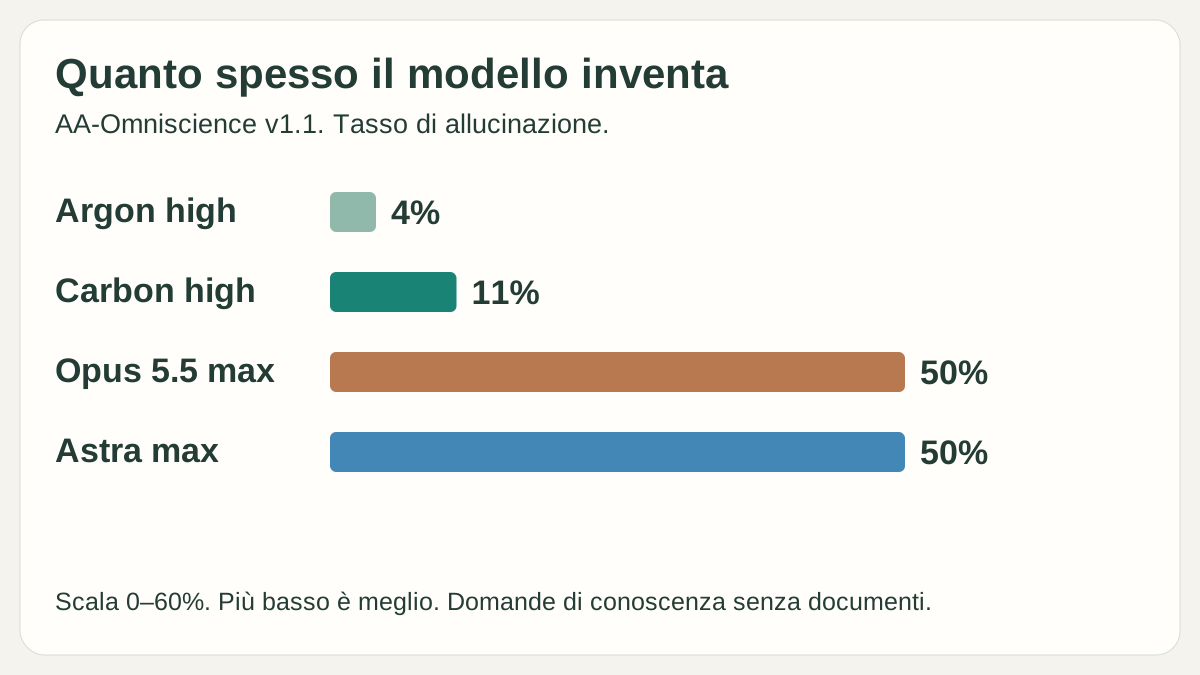
- Su AA-Omniscience sbaglia l'11% delle volte contro il 50% di Opus 5.5 e GPT-6 Astra: è il vantaggio più netto per chi fa ricerca.
- Argon è disponibile nell'API come gemini-4-argon a $2/$10 per 1M token fino al 30 novembre, poi $4/$20.
- Un abbonamento Pro o Ultra oggi include Argon, non Carbon: non abbonarti per avere Carbon.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Risultati di Carbon e dei rivali | Cosa cambia per la scelta |
|---|---|---|
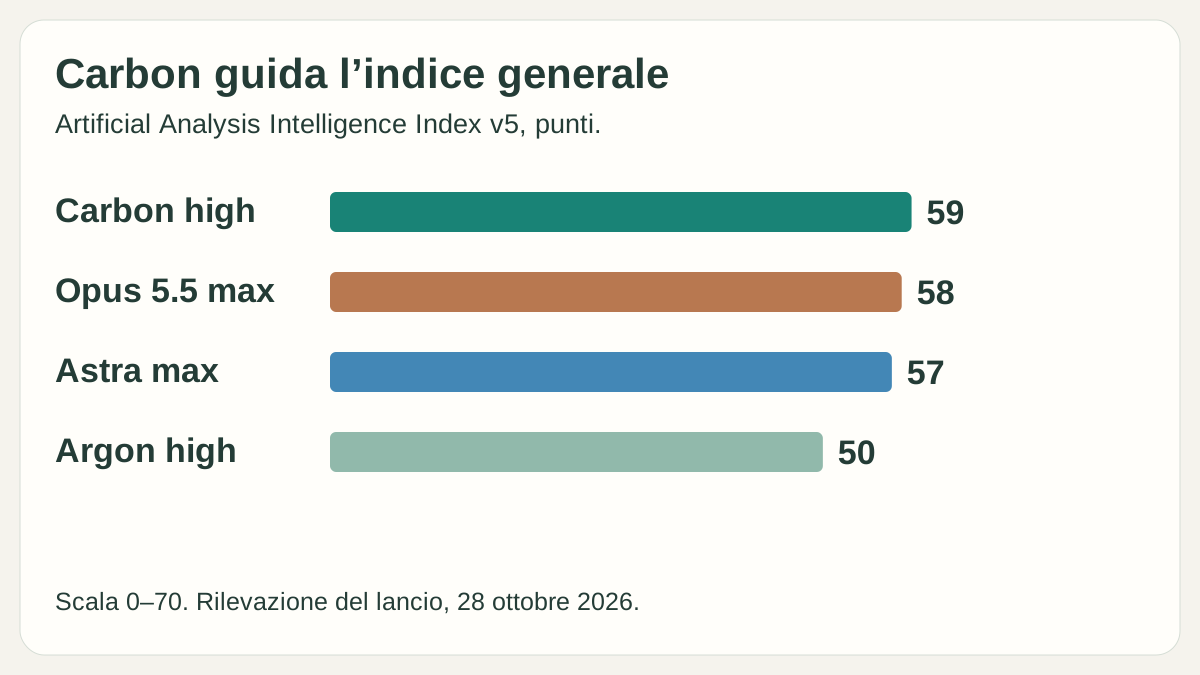
| Indice generale | AA Index v5: Carbon 59, Opus 5.5 58, Astra 57, Argon 50, Fable 5.1 49. Vals Index: Carbon 70,4%, Opus 5.5 70,2%, Argon 69,2%, Astra 65,0%. | Carbon è primo, ma su Opus il margine è di un punto e su Vals rientra nell'incertezza dichiarata di ±0,97. Nella classifica Vals completa Claude Sonnet 5.5 resta davanti con 70,85%. |
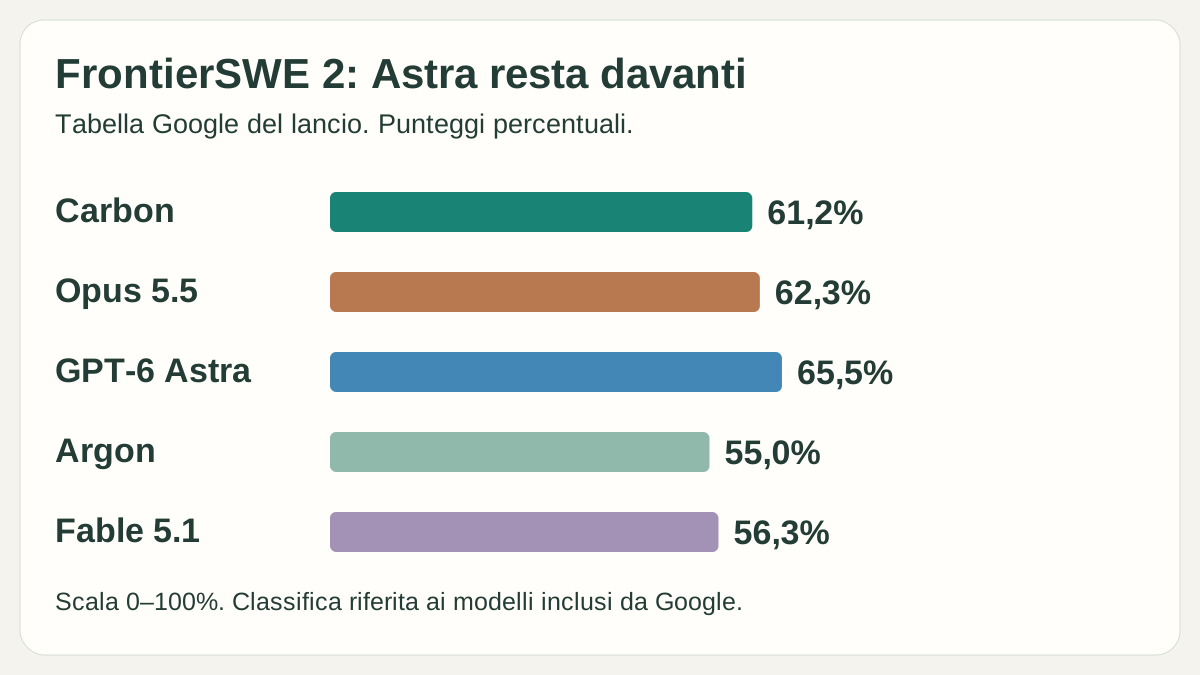
| Coding agentico | FrontierSWE 2: Astra 65,5%, Opus 5.5 62,3%, Carbon 61,2%. Terminal-Bench 4.0: Carbon 65,2% nella tabella Google (Opus 59,6%, Astra 59,1%), ma Artificial Analysis riporta 64% e lo mette secondo dietro Opus 5.5. SWE-sweep: Carbon 9,6%, Astra 9,5%, Opus 3,6%. | Risultati contrastanti. Il Coding Agent Index di AA, che misura modello e ambiente insieme, mette Claude Code con Opus 5.5 a 62 contro 59 di Carbon con Antigravity CLI. Per un agente sul repository, Opus resta il riferimento. |
| Uso del computer | OSWorld 2.1 offline: Opus 5.5 87,2%, Carbon 81,5%, Astra 80,9%. Agents' Last Exam v1.1: Carbon 77,4%, Astra 73,1%, Opus 71,6%. | Se l'agente deve controllare un desktop, Opus è avanti di quasi 6 punti, anche se il valore di Carbon è il migliore di tre esecuzioni. Agents' Last Exam premia invece Carbon su compiti lunghi con strumenti. |
| Lavoro d'ufficio e automazioni | AutomationBench (Zapier): Carbon 53,9%, Argon 51,3%, Opus 42,5%, Astra 41,4%. Vending-Bench 2: Carbon $16.484, Astra $15.515, Opus $9.235. | È il distacco più ampio sui rivali, misurato da terzi. Vals mette Carbon primo anche su Finance Index e Legal Research Bench. Il vantaggio però era già di Argon: qui Carbon aggiunge solo 2,6 punti. |
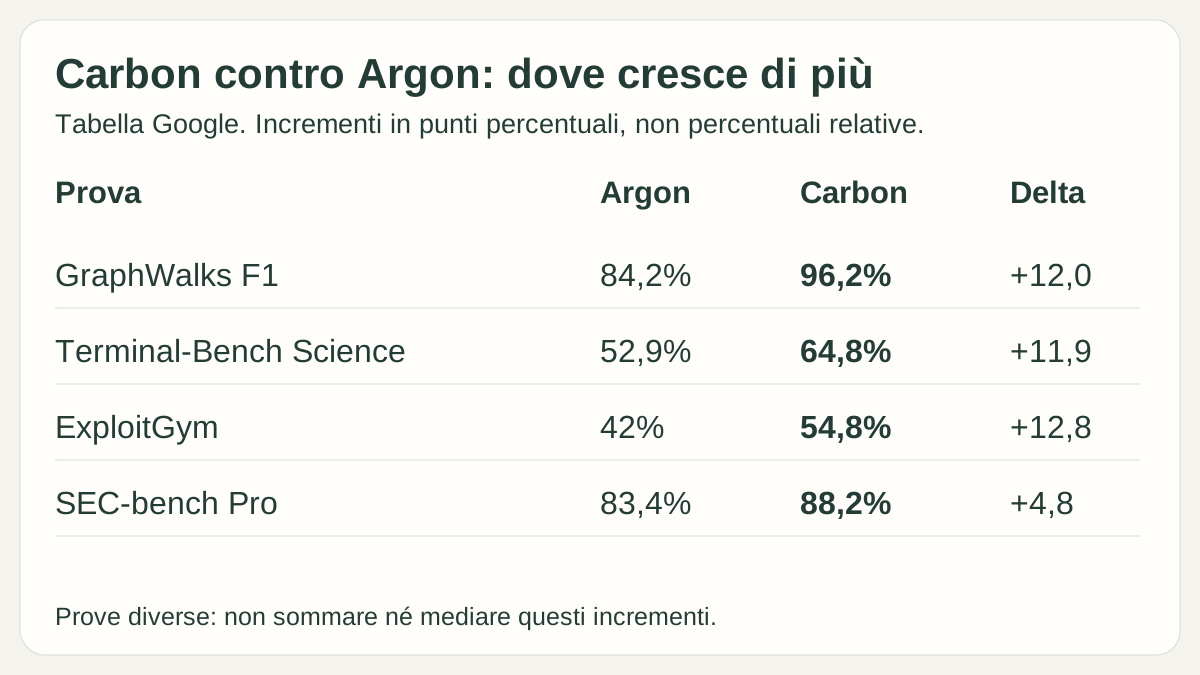
| Documenti lunghi, grafici e progetti | GraphWalks 256K-1M (F1): Carbon 96,2%, Argon 84,2%, Astra 71,8%, Opus 66,8%. Chartography: Carbon 72,5%, Argon 71,6%, Astra 71,0%. Blueprint-Bench 2: Carbon 58,6%, Argon 54,4%. | Sui contesti fra 256.000 e 1 milione di token il distacco è netto e Google ha misurato tutti i modelli con lo stesso setup. Su grafici e planimetrie i margini sono stretti. |
| Scienza e matematica | RiemannBench: Carbon 80,0%, Argon 76,0%, Astra 72,0%, Opus 69,6%. Terminal-Bench-Science 0.1 (AA): Carbon 64,8%, Astra 63,3%, Opus 59,0%. | Primo in entrambe, con un margine di soli 1,5 punti su Astra nella ricerca computazionale da terminale. Su Argon il salto è di quasi 12 punti. |
| Cybersecurity | SEC-bench Pro: Carbon 88,2%, Astra 85,4%, Argon 83,4%. ExploitGym: Carbon 54,8%, Astra 42,4%, Argon 42,0%, Opus 34,5%. CWE-bench: Carbon 71,0%, Argon e Astra 68,0%, Opus 67,0%. | È il punto di forza dichiarato da Google, misurato senza protezioni. Solo CWE-bench è valutato da terzi su tutti i modelli, e lì il vantaggio è di soli 3 punti. Opus 5.5 non ha un valore pubblicato su SEC-bench Pro. |
| Affidabilità delle risposte | AA-Omniscience v1.1: Carbon 54 punti, Opus 5.5 48, Argon 46. Tasso di allucinazione: Argon 4%, Carbon 11%, Opus 5.5 e Astra 50%. | Carbon dà più risposte corrette di Argon (58%, +10 punti) ma ne inventa di più. Rispetto ai modelli di punta di Anthropic e OpenAI resta molto più prudente. |
Applicazione
Quanto costa rispetto a Claude, GPT e Argon
Carbon ha lo stesso listino annunciato di Argon: $2 input e $10 output per milione di token al lancio, poi $4 e $20, con il 95% di sconto sui token in cache. Per Argon la promozione finisce il 30 novembre 2026; per Carbon Google non indica la durata. Per i rivali usiamo i listini ufficiali: Opus 5.5 $4/$20, GPT-6 Astra e Fable 5.1 $10/$50. Gli esempi escludono strumenti, imposte e tentativi aggiuntivi.
Una richiesta con documenti
100.000 token input · 20.000 token output
- Gemini Carbon
- $0,40 al lancio, $0,80 a prezzo pieno
- Rivali allo stesso volume
- Opus 5.5: $0,80 · Astra e Fable 5.1: $2,00 · Argon: $0,40 fino al 30 novembre
Al lancio Carbon costa un quinto di Astra e Fable. A prezzo pieno costa quanto Opus 5.5: la scelta torna a dipendere dalla qualità sul tuo lavoro.
Un task completo misurato da AA
Media dell'Intelligence Index · 123.000 token output per task per Carbon
- Gemini Carbon
- $7,76 a prezzo pieno
- Rivali allo stesso volume
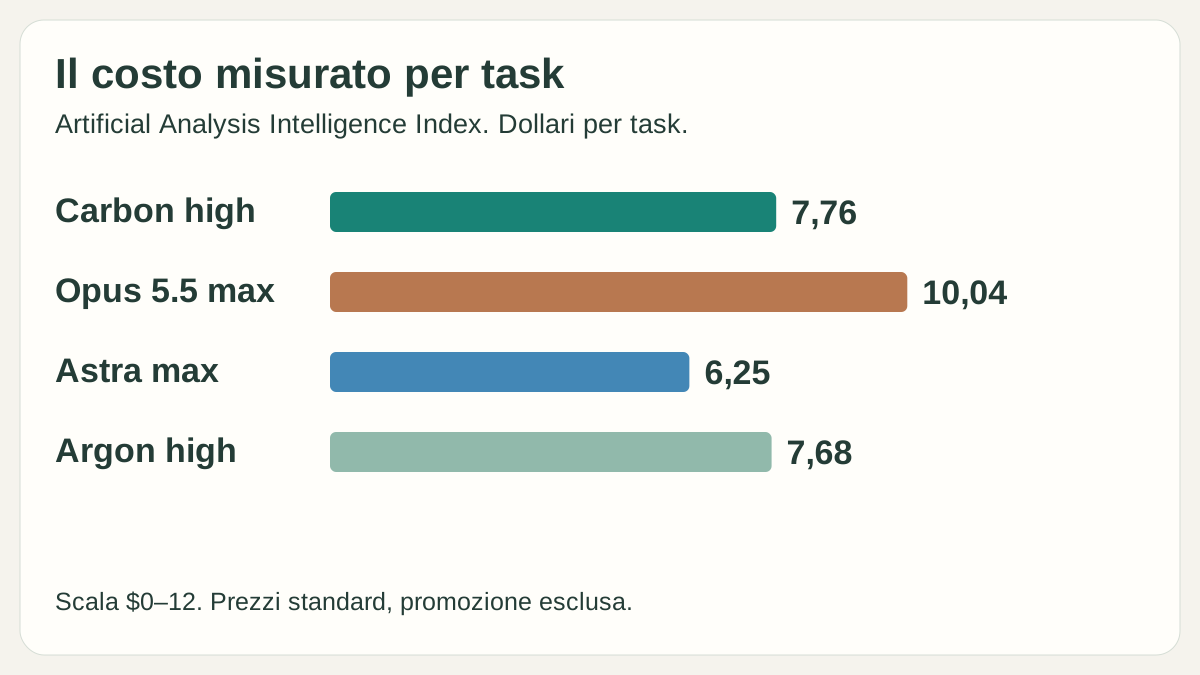
- Opus 5.5: $10,04 · Astra: $6,25 · Argon: $7,68
Carbon costa il 23% meno di Opus a parità di listino: genera circa il 29% di token in meno. Astra, con un listino 2,5 volte più alto, costa meno per task: conta quanto ragiona il modello, non solo il prezzo per token.
Un agente che rilegge lo stesso contesto
10 milioni di token letti dalla cache · 50.000 token output
- Gemini Carbon
- $1,50 al lancio, $3,00 a prezzo pieno
- Rivali allo stesso volume
- Opus 5.5: $3,00
Con lo sconto del 95% la cache di Carbon a prezzo pieno costa $0,20 per milione, come quella di Opus 5.5. Nei loop lunghi i due listini si equivalgono.
Che cos'è Gemini 4 Carbon
Gemini 4 Carbon è il modello di frontiera di Google DeepMind annunciato il 28 ottobre 2026. Nasce da Gemini 4 Argon, arrivato nell'API il 13 ottobre, e Google lo presenta come il suo modello più forte per la difesa informatica e per i lavori lunghi in più passaggi. Secondo Google, i team interni lo hanno fatto lavorare per giorni su compiti di ingegneria complessi.
- Artificial Analysis riporta una finestra di contesto di 1 milione di token, input di testo, immagini, video e voce e output solo testuale.
- Google non ha ancora pubblicato il nome del modello nell'API, il limite di output e la velocità di generazione.
- Il listino annunciato è lo stesso di Argon: il salto di qualità non aumenta il prezzo per token.
Chi può usarlo oggi e cosa usare nel frattempo
Carbon parte da un gruppo ristretto di difensori cyber e si estenderà gradualmente ad altri partner fidati tramite il programma Fairwind, che dà priorità a governi, autorità cyber, infrastrutture critiche e grandi piattaforme tecnologiche. Google partecipa anche ai test volontari del governo statunitense prima del rilascio. Sviluppatori, aziende e utenti dell'app Gemini lo riceveranno più avanti, senza una data.
- Nell'API usa Argon: l'ID è gemini-4-argon, costa $2/$10 per 1M token fino al 30 novembre 2026 e $4/$20 dal 1° dicembre, con Batch a metà prezzo.
- Nell'app Gemini Argon è incluso in Google AI Pro, 21,99 euro al mese in Italia, e con limiti più alti in Ultra, da 99,99 euro al mese.
- Argon non è disponibile nel piano gratuito né nel livello gratuito dell'API.
- Non pianificare una migrazione su Carbon finché non compare nell'API o nel selettore modelli del tuo account.
Dove il primato regge
I vantaggi più solidi di Carbon sono quelli misurati da terzi o con lo stesso setup per tutti i modelli: documenti molto lunghi, automazioni aziendali, ricerca finanziaria e legale. Su GraphWalks, fra 256.000 e 1 milione di token, supera Astra di oltre 24 punti e Opus di quasi 30. Su AutomationBench di Zapier ha più di 11 punti su Opus. Se il tuo lavoro somiglia a queste prove, Carbon è il primo modello da provare quando sarà disponibile.
- Vals AI lo mette primo su 33 modelli nel Finance Index e primo su 87 nel Legal Research Bench.
- Su AA-Briefcase, lavoro professionale con agenti, sale a 1609 Elo da 1483 di Argon, ma resta dietro a Kimi K3.1 Pro, Muse Wonder e Grok 4.7.
- Su Vending-Bench 2, la gestione simulata di un negozio, chiude con più soldi di tutti: è un indizio sulla tenuta in compiti lunghi, non una stima di ritorno economico.
Per il coding, Claude resta il riferimento
Nella tabella Google Carbon è dietro ad Astra e Opus su FrontierSWE 2 e dietro a Opus di quasi 6 punti su OSWorld. Il dato più vicino a una scelta reale è il Coding Agent Index di Artificial Analysis, che misura modello e ambiente di lavoro insieme: Claude Code con Opus 5.5 segna 62, Carbon con Antigravity CLI 59. AA lo colloca secondo anche su FrontierCode, con 51% contro 56% di Opus.
- Su Terminal-Bench 4.0 la tabella Google dà Carbon primo con 65,2%, ma per Artificial Analysis Opus 5.5 resta davanti.
- Google riporta che su WebDev Arena, sviluppo di interfacce web votato dagli utenti, Carbon sale di 89 punti a 1768 ed è quarto.
- Google dichiara di aver portato a 0% i tentativi riusciti di aggirare i test di Terminal-Bench: conta se lasci l'agente lavorare senza supervisione.
- Per un confronto onesto ripeti issue già risolte, con gli stessi test e lo stesso ambiente, e misura tentativi, regressioni e minuti di revisione.
Allucinazioni: il dato che cambia il confronto
Su AA-Omniscience v1.1, una prova di conoscenza di Artificial Analysis che penalizza le risposte inventate, Carbon ottiene 54 punti contro 48 di Opus 5.5 e 46 di Argon. Le risposte corrette salgono al 58%, ma il tasso di allucinazione cresce dal 4% di Argon all'11%. Resta comunque il secondo più basso fra tutti i modelli misurati: Opus 5.5 e Astra sono al 50%.
- Se usi l'AI per ricerca o domande su fatti, la differenza con Opus e Astra è più rilevante del punto di vantaggio nell'indice generale.
- Google dichiara circa la metà di affermazioni non supportate rispetto ad Argon nei propri test interni, e attacchi di prompt injection riusciti scesi dallo 0,7% allo 0% sul benchmark di Gray Swan.
- Nessuna di queste misure riguarda i tuoi documenti: per report e analisi continua a chiedere le fonti e a verificarle.
Cybersecurity: numeri forti, ma senza protezioni
Google riporta 88,2% su SEC-bench Pro per trovare vulnerabilità, 54,8% su ExploitGym per dimostrarne lo sfruttamento e 71,0% su CWE-bench per correggerle. Su ExploitGym Carbon supera Astra di oltre 12 punti e Opus di 20. Google dichiara di aver eseguito le prove esterne senza filtri di sicurezza: il modello distribuito, con le protezioni attive, può rifiutare parte di queste richieste.
- ExploitGym e SEC-bench Pro sono calcolati da Google con il proprio ambiente Antigravity; i valori dei rivali vengono dai loro report.
- CWE-bench è l'unica prova cyber valutata da terzi, Collinear AI, su tutti i modelli: qui il margine su Argon e Astra è di 3 punti.
- Google dichiara anche il doppio dei successi rispetto ad Argon nel generare codice sicuro, in test interni.
Quanto pesa il costo quando l'agente lavora a lungo
Il listino per token dice poco da solo. Artificial Analysis misura $7,76 per task dell'Intelligence Index per Carbon al prezzo pieno, contro $10,04 di Opus 5.5, $6,25 di Astra e $7,68 di Argon. Carbon e Opus hanno lo stesso listino, ma Carbon usa 123.000 token di output per task contro 173.000. Astra costa $10/$50 e chiude comunque il task con meno spesa.
- Carbon resta un modello che ragiona molto: per completare l'intero indice AA ha generato 200 milioni di token di output, contro una mediana di 64 milioni.
- Vals stima $10,51 per test sul proprio indice, a reasoning high.
- Stima il budget al prezzo pieno di $4/$20: per Argon la promozione scade il 30 novembre e per Carbon la durata non è annunciata.
- Per una tua automazione somma tutti i tentativi e dividi la spesa per i lavori accettati, aggiungendo il tempo di revisione.
Come leggere i numeri di Google
La tabella del lancio mescola tre tipi di dati: punteggi calcolati da Google, classifiche gestite da terzi e valori dichiarati dagli altri fornitori. Carbon gira al livello di ragionamento più alto, i rivali al massimo disponibile. Su OSWorld Google riporta il migliore di tre esecuzioni e solo le 82 attività senza internet; su GraphWalks ha misurato tutti i modelli; AA Index, Vals, AutomationBench, FrontierSWE e CWE-bench vengono interamente da terzi.
- Lo stesso test può dare valori diversi: su Terminal-Bench 4.0 la tabella Google riporta 65,2% e il primo posto, AA 64% e il secondo, Vals 63,13% e il quarto su 57.
- Vending-Bench è un saldo in dollari e GraphWalks un F1: non leggerli come percentuali di lavori completati.
- Le celle senza valore indicano risultati non pubblicati, non punteggi pari a zero: Fable 5.1 manca su Vals Index, Agents' Last Exam, ExploitGym e SEC-bench Pro, Opus 5.5 su SEC-bench Pro.
Cosa fare oggi se stai scegliendo un modello
Carbon non cambia le scelte che puoi fare questa settimana, ma cambia cosa conviene preparare. Se usi già Gemini nell'API, passa ad Argon finché la promozione è attiva: Carbon arriverà con lo stesso listino e potrai confrontarli sugli stessi compiti. Se usi Claude o GPT per coding agentico, non hai motivi per cambiare. Se il tuo lavoro è analisi di documenti lunghi, ricerca o automazioni, prepara ora il test.
- Scegli da 5 a 10 compiti reali per ogni tipo di lavoro importante, con un criterio chiaro di riuscita.
- Registra costo, durata, tentativi e minuti di revisione con il modello che usi oggi.
- Quando Carbon compare nel tuo account, ripeti gli stessi compiti con gli stessi strumenti e confronta il costo per lavoro accettato.
ChatGPT o Gemini per il lavoro quotidiano? Confronta le integrazioni
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Gemini 4 Carbon è migliore di Claude Opus 5.5?
Dipende dal compito. Carbon guida l'Intelligence Index di Artificial Analysis con 59 punti contro 58 e inventa molte meno risposte su AA-Omniscience. Nel coding agentico, però, Claude Code con Opus 5.5 resta avanti nel Coding Agent Index, 62 contro 59, e Opus vince su OSWorld.
Gemini Carbon batte GPT-6 Astra?
In 16 delle 17 prove della tabella Google sì. Astra resta davanti su FrontierSWE 2, 65,5% contro 61,2%, e nel test di Artificial Analysis costa meno per task completato: $6,25 contro $7,76.
Quando potrò usare Gemini 4 Carbon?
Google non ha indicato una data. Oggi Carbon è riservato a difensori cyber selezionati e si estenderà ad altri partner tramite il programma Fairwind. Sviluppatori, aziende e utenti dell'app Gemini lo riceveranno in seguito.
Google AI Pro e Ultra includono Gemini Carbon?
No, al 29 ottobre 2026 includono Gemini 4 Argon. Google non ha annunciato quali piani riceveranno Carbon, quindi non abbonarti contando su un accesso non confermato.
Quanto costa Gemini Carbon via API?
Google annuncia $2 per milione di token input e $10 per milione di token output al lancio, poi $4 e $20, come Opus 5.5. I token in cache hanno uno sconto del 95%. La durata del prezzo di lancio non è indicata.
Gemini Carbon inventa meno risposte degli altri modelli?
Rispetto a Opus 5.5 e GPT-6 Astra sì: su AA-Omniscience il suo tasso di allucinazione è 11%, contro il 50% di entrambi. Rispetto ad Argon, fermo al 4%, è peggiorato, anche se dà più risposte corrette.
Conviene usare Gemini 4 Argon nell'attesa?
Sì, se vuoi un modello Google di punta oggi. Argon è disponibile nell'API come gemini-4-argon a $2/$10 per 1M token fino al 30 novembre 2026, poi $4/$20, e nei piani Google AI Pro e Ultra. Resta dietro a Carbon di 9 punti nell'indice AA.
Prossime letture