Modelli AI frontier: Opus, Fable, GPT o Gemini?
Cosa dicono i benchmark di Anthropic, OpenAI e Google, quanto costano e come scegliere sul tuo lavoro
Entra nell'analisi
Risposta breve
Parti da Claude Opus 5.5 per coding, knowledge work e analisi complesse: supera Fable 5.1 in ogni riga della tabella Anthropic e costa meno della metà. Se lavori con strumenti OpenAI, prova GPT-6.1 Sol prima di GPT-6 Astra, che resta davanti su automazioni e ricerca scientifica. Fable 5.1 è un'escalation da giustificare con i tuoi eval. Gemini 4 Argon è promettente nei test Google, ma al lancio è riservato a un gruppo ristretto.
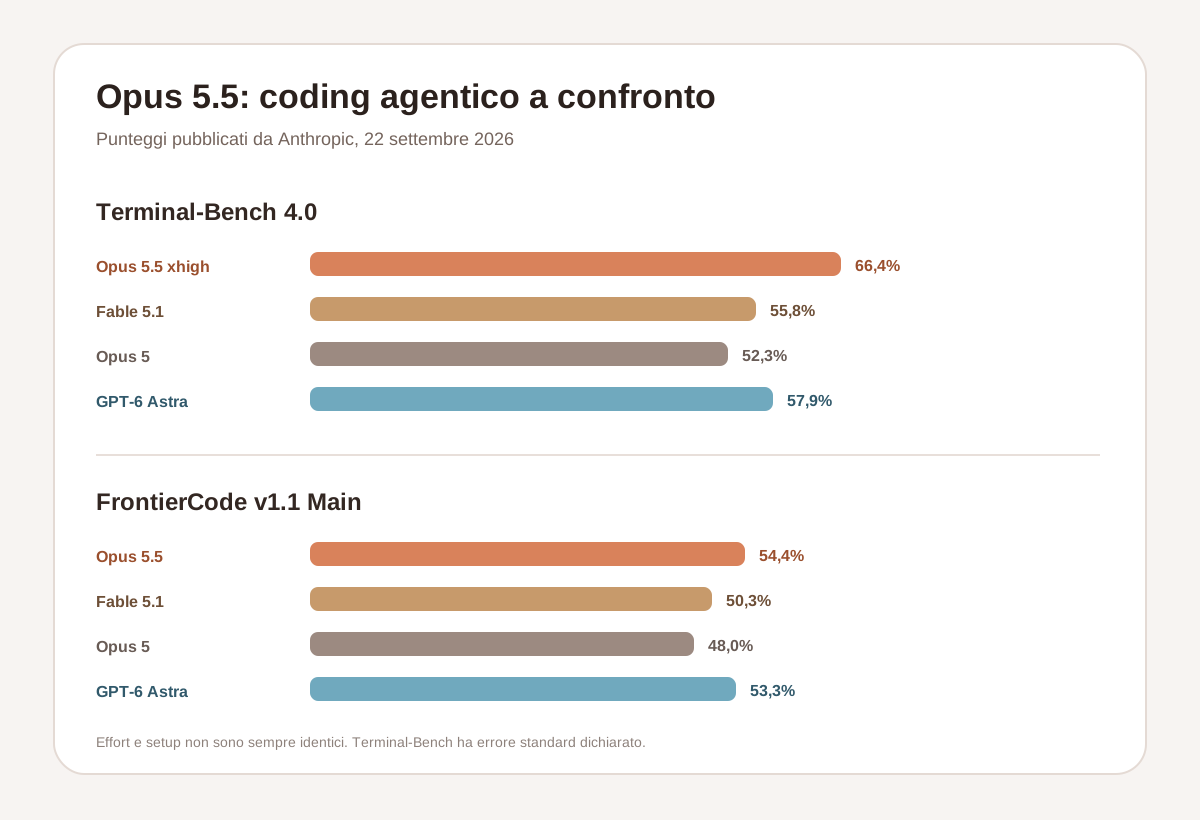
- Coding e knowledge work: Opus 5.5 guida Terminal-Bench 4.0 con il 66,4%, davanti ad Astra e Fable 5.1.
- Strumenti OpenAI: GPT-6.1 Sol costa $2/$10 per 1M token, un quinto di Astra.
- Automazioni e ricerca scientifica: GPT-6 Astra guida AutomationBench e Terminal-Bench-Science.
- Agenti molto lunghi: prova Fable 5.1 solo dove i tuoi eval mostrano più task accettati.
- Gemini 4 Argon vince molte righe della tabella Google, ma va testato quando è disponibile per te.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Risultato pubblicato | Lettura pratica |
|---|---|---|
| Terminal-Bench 4.0 | Opus 5.5 66,4% a xhigh effort, GPT-6 Astra 57,9%, Fable 5.1 55,8%. | Per il coding agentico da terminale Opus 5.5 ha il margine più ampio della tabella. |
| FrontierCode v1.1 | Opus 5.5 54,4%, GPT-6 Astra 53,3%, Fable 5.1 50,3%. | Opus e Astra sono quasi alla pari: decide il test sul tuo repository. |
| CursorBench 4.0 | Opus 5.5 57,8%, Fable 5.1 51,8%, Opus 5 46,6%. | Conta soprattutto se lavori dentro Cursor. |
| GDPval-AA v2.1 | Opus 5.5 1846, Fable 5.1 1735, GPT-6 Astra 1542. | Su documenti e knowledge work i modelli Claude restano davanti ad Astra. |
| OSWorld 2.0 | Opus 5.5 81,8%, Fable 5.1 80,7%. | Nel computer use i due modelli Claude sono quasi equivalenti: il prezzo decide. |
| Humanity's Last Exam con tool | Opus 5.5 67,7%, Fable 5.1 65,6%, GPT-6 Astra 57,2%. | Nel ragionamento con strumenti Opus 5.5 è avanti di oltre dieci punti su Astra. |
| AutomationBench | GPT-6 Astra 41,4%, Opus 5.5 40,0%, Fable 5.1 31,4%. | Astra e Opus sono vicini; nessun modello chiude metà dei task, quindi la supervisione resta necessaria. |
| Terminal-Bench-Science 0.1 | GPT-6 Astra 64,6%, Opus 5.5 58,7%, Fable 5.1 52,6%. | Per la ricerca computazionale con terminale Astra è il modello da battere. |
| Prezzo API per 1M token | Opus 5.5 $4/$20, GPT-6.1 Sol $2/$10, GPT-6 Astra e Fable 5.1 $10/$50. | A risultato simile, il listino sposta la scelta verso Opus 5.5 o GPT-6.1 Sol. |
Applicazione
Tre segnali per scegliere
I punteggi vengono dalla tabella pubblicata da Anthropic al lancio di Opus 5.5, il 22 settembre 2026, verificata il 23 settembre. I prezzi sono i listini ufficiali per 1M token. Non sono una classifica universale e non hanno tutti lo stesso setup.
Coding agentico
Terminal-Bench 4.0 · Accuracy
- Numero
- Opus 5.5: 66,4%
- Cosa misura
- Astra 57,9%, Fable 5.1 55,8%
È il vantaggio più netto di Opus 5.5. Confermalo sul tuo repository con lo stesso harness prima di cambiare modello.
Ricerca scientifica agentica
Terminal-Bench-Science 0.1 · Accuracy
- Numero
- GPT-6 Astra: 64,6%
- Cosa misura
- Opus 5.5 58,7%, Fable 5.1 52,6%
Qui Astra è davanti di sei punti. Conta per ricerca computazionale con terminale e strumenti, non per domande scientifiche in chat.
Knowledge work
GDPval-AA v2.1 · Punteggio Elo
- Numero
- Opus 5.5: 1846
- Cosa misura
- Fable 5.1 1735, Astra 1542
Per documenti, analisi e lavoro d'ufficio i modelli Claude restano avanti. Astra recupera su automazioni e scienza.
Cosa scegliere oggi
Opus 5.5 è il punto di partenza più sensato per la maggior parte dei task complessi: nella tabella Anthropic supera Fable 5.1 e costa meno della metà su input e output. Nell'ecosistema OpenAI la stessa logica vale per GPT-6.1 Sol rispetto ad Astra. Fable 5.1 e Astra restano escalation per i task in cui i tuoi eval mostrano un vantaggio ripetibile. Se il costo pesa più dell'ultimo punto di qualità, Kimi K3 a $3/$15 per 1M token è l'alternativa con pesi aperti da mettere nello stesso test.
- Parti da Opus 5.5 per coding, knowledge work e analisi complesse.
- Con strumenti OpenAI prova GPT-6.1 Sol e passa ad Astra solo per automazioni difficili o ricerca scientifica.
- Prova Fable 5.1 solo dove completa più task accettati o riduce la supervisione.
- Tieni Gemini 4 Argon tra i candidati da testare quando sarà disponibile per il tuo account.
- Non scegliere un modello soltanto perché guida una media di benchmark eterogenei.
Cosa cambia con Opus 5.5 e GPT-6 Astra
Le tabelle qui sopra vengono dal lancio di Fable 5.1, quando i rivali erano Opus 5 e GPT-5.6 Sol. Il 22 settembre 2026 Anthropic ha pubblicato Opus 5.5 con una nuova tabella che include anche GPT-6 Astra. Alcune versioni dei benchmark sono cambiate, per esempio CursorBench 4.0 e GDPval-AA v2.1, quindi i numeri non vanno confrontati riga per riga con quelli del lancio di Fable.
- Terminal-Bench 4.0: Opus 5.5 66,4% a xhigh effort, GPT-6 Astra 57,9%, Fable 5.1 55,8%.
- FrontierCode v1.1: Opus 5.5 54,4%, GPT-6 Astra 53,3%, Fable 5.1 50,3%.
- CursorBench 4.0: Opus 5.5 57,8%, Fable 5.1 51,8%, Opus 5 46,6%.
- GDPval-AA v2.1: Opus 5.5 1846, Fable 5.1 1735, GPT-6 Astra 1542.
- OSWorld 2.0: Opus 5.5 81,8%, Fable 5.1 80,7%.
- Humanity's Last Exam con tool: Opus 5.5 67,7%, Fable 5.1 65,6%, GPT-6 Astra 57,2%.
- AutomationBench: GPT-6 Astra 41,4%, Opus 5.5 40,0%, Fable 5.1 31,4%.
- Terminal-Bench-Science 0.1: GPT-6 Astra 64,6%, Opus 5.5 58,7%, Fable 5.1 52,6%.
Il salto rispetto a Fable 5
I miglioramenti più grandi non compaiono ovunque. Terminal-Bench-Science più che raddoppia, AutomationBench cresce di oltre 14 punti e Terminal-Bench 4.0 guadagna quasi 14 punti. Su CursorBench, OSWorld e HLE il salto è invece più contenuto.
- Terminal-Bench-Science: 52,6% contro 24,7%.
- AutomationBench: 31,4% contro 17,1%.
- Terminal-Bench 4.0: 55,8% contro 42,0%.
- CursorBench: 73,4% contro 70,5%.
- HLE con tool: 65,0% contro 63,8%.
Dove Opus 5 resta vicino
Il confronto più utile non è sempre con il modello precedente. Opus 5 costa la metà di Fable 5.1 su input nuovo e output e resta entro pochi punti su coding, knowledge work, computer use e ragionamento con strumenti. Per molti team, questo rende Opus il baseline da battere.
- Terminal-Bench 4.0: 52,3% contro 55,8%.
- GDPval-AA v2: 1824 contro 1853.
- OSWorld partial: 75,4% contro 77,9%.
- HLE con tool: 63,6% contro 65,0%.
- CursorBench: 70,0% contro 73,4%.
Perché la classifica non basta
I benchmark misurano modelli, harness e regole diverse. Anthropic ha valutato Fable 5.1 con safeguards di produzione e segnala che alcuni interventi portano a uno zero o a un fallback verso Opus. Anche effort, strumenti e versione dei task cambiano il risultato.
- Controlla se il test usa il modello puro o un agente completo.
- Verifica effort, tool, retry, fallback e criterio di punteggio.
- Non confrontare versioni diverse dello stesso benchmark come se fossero identiche.
- Distingui il risultato di Fable da quello di Mythos 5.1, che ha safeguards differenti.
- Aspetta conferme indipendenti prima di trasformare la tabella del lancio in una regola generale.
Prezzo e cache cambiano il verdetto
Fable 5.1 mantiene $10/$50 per 1M token input/output e $0,25 per la cache read. Opus 5.5 costa $4/$20 e $0,20 per la cache read: meno di Fable su ogni voce. Il vantaggio di cache che Fable 5.1 aveva su Opus 5, fermo a $0,50, non vale con Opus 5.5.
- Calcola input nuovo, cache write, cache read e output separatamente.
- Misura il costo per task accettato, includendo retry e supervisione.
- Non applicare il risparmio dichiarato del 25-45% a ogni workload.
- Confronta Fable 5.1 e Opus 5.5 sullo stesso prompt, con gli stessi tool e lo stesso livello di effort.
Un test che vale più della leaderboard
Scegli un campione di task reali, non una raccolta di prompt dimostrativi. Per il coding usa issue chiuse, test e review; per ricerca e knowledge work usa fonti note, calcoli controllabili e un criterio di completezza definito prima della prova.
- Esegui almeno cinque task per categoria.
- Nascondi il nome del modello a chi valuta l'output quando possibile.
- Registra completamento, errori, retry, costo e tempo umano.
- Separa qualità del modello da qualità dell'harness e degli strumenti.
- Promuovi Fable solo dove il vantaggio si ripete e copre il costo aggiuntivo.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Quale modello frontier conviene provare per primo?
Per la maggior parte dei task complessi Claude Opus 5.5, che nella tabella Anthropic supera Fable 5.1 e costa $4/$20 per 1M token. Se il tuo lavoro passa già da ChatGPT, Codex o dalle API OpenAI, parti da GPT-6.1 Sol a $2/$10 e confronta i due modelli sugli stessi task.
Opus 5, GPT-5.6 Sol e Kimi K3 sono ancora i riferimenti?
No. Opus 5.5 ha sostituito Opus 5 e la famiglia GPT-6 ha sostituito GPT-5.6 Sol, entrambi con listini più bassi. Kimi K3 resta il modello di punta di Moonshot: per il confronto con Claude vedi la guida dedicata a Kimi.
Fable 5.1 è ancora il modello Claude migliore nei benchmark?
No. Nella tabella pubblicata da Anthropic il 22 settembre 2026, Opus 5.5 supera Fable 5.1 in tutte le righe, da Terminal-Bench 4.0 a GDPval-AA v2.1, e costa $4/$20 per 1M token contro $10/$50. Fable resta da provare su task molto lunghi, ma va giustificato con eval sul tuo lavoro.
Fable 5.1 batte Opus 5 nei benchmark?
Sì, in tutti i confronti riportati nella tabella di lancio Anthropic. I margini variano: sono ampi su Terminal-Bench-Science e più contenuti su GDPval, OSWorld, HLE con strumenti e CursorBench. Sono dati del provider e vanno confermati sul proprio workflow.
Fable 5.1 batte GPT-5.6 Sol?
Nelle righe in cui Anthropic riporta GPT-5.6 Sol, Fable 5.1 è davanti. Contro GPT-6 Astra il quadro cambia: Astra è avanti su Terminal-Bench 4.0, AutomationBench e Terminal-Bench-Science, Fable su GDPval-AA e Humanity's Last Exam. Il confronto non misura il valore delle integrazioni con ChatGPT o Codex.
Qual è il benchmark più convincente per Fable 5.1?
Terminal-Bench-Science 0.1 mostra il salto più grande, 52,6% contro 24,7% di Fable 5 e 29,0% di Opus 5. È rilevante per ricerca scientifica agentica con terminale e strumenti, non per ogni uso scientifico.
I benchmark Anthropic sono indipendenti?
No. Alcuni benchmark sono di terze parti, ma configurazione, esecuzione e tabella comparativa sono pubblicate dal vendor. Sono una fonte primaria per il lancio, non una verifica indipendente della superiorità generale del modello.
Quando un benchmark giustifica pagare Fable 5.1?
Quando il test assomiglia al tuo lavoro e il vantaggio si ripete su task reali, riducendo errori, retry o supervisione abbastanza da coprire il costo. Se Opus completa lo stesso lavoro, il punteggio più alto di Fable può non avere valore economico.
Prossime letture