Claude Fable 5.1 vs Opus 5.5
Quando il modello più costoso giustifica ancora il prezzo
Entra nell'analisi
Risposta breve
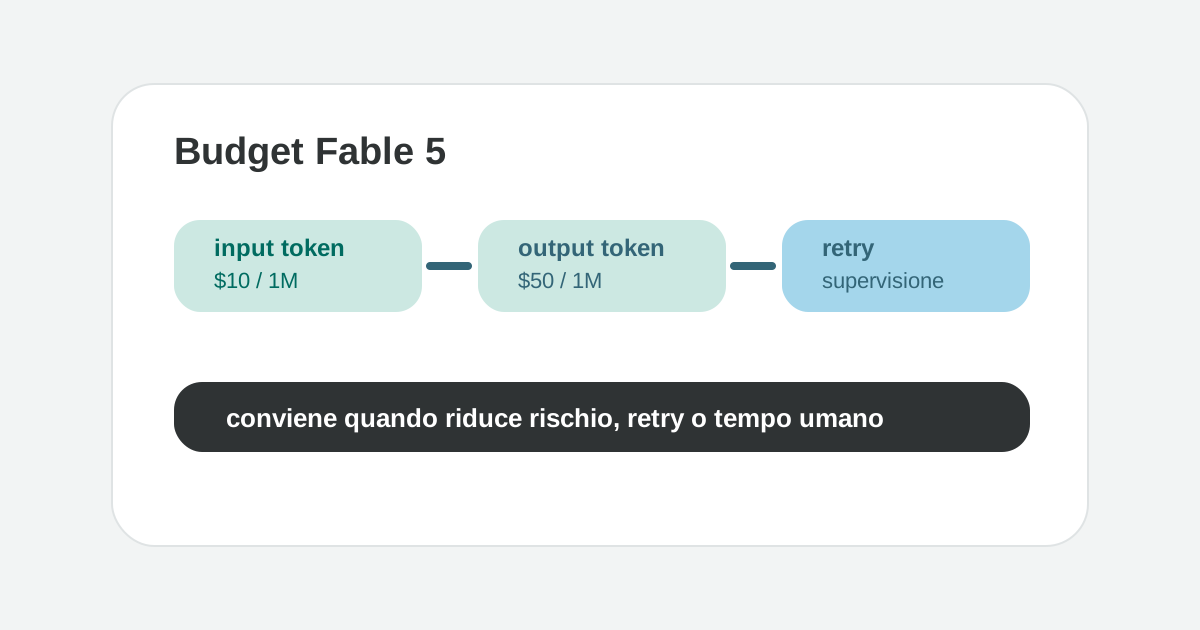
Parti da Opus 5.5 per la maggior parte dei workload complessi: costa $4 input e $20 output per 1M token e nei benchmark Anthropic supera spesso Fable 5.1. Prova Fable soltanto quando un eval sul tuo lavoro mostra più task completati o meno supervisione. A $10/$50, il vantaggio deve essere netto per recuperare il costo.
- La cache read costa $0,25 per Fable 5.1 e $0,20 per Opus 5.5.
- Opus 5.5 guida Terminal-Bench, FrontierCode, CursorBench e GDPval-AA nella tabella Anthropic.
- I margini di benchmark non sono sempre superiori all'errore standard dichiarato.
- Su Claude Pro e Team Standard, Fable 5.1 usa crediti a consumo fin dalla prima richiesta.
- I risultati disponibili sono soprattutto del vendor: la scelta finale richiede eval sul proprio lavoro.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Ruolo consigliato | Punto di partenza per la maggior parte dei workload complessi. | Escalation per ragionamento difficile e agenti di lunga durata quando gli eval di Opus non bastano. |
| Prezzo API | $4 input e $20 output per 1M token. | $10 input e $50 output per 1M token. |
| Prompt cache read | $0,20 per 1M token letti dalla cache. | $0,25 per 1M token letti dalla cache. |
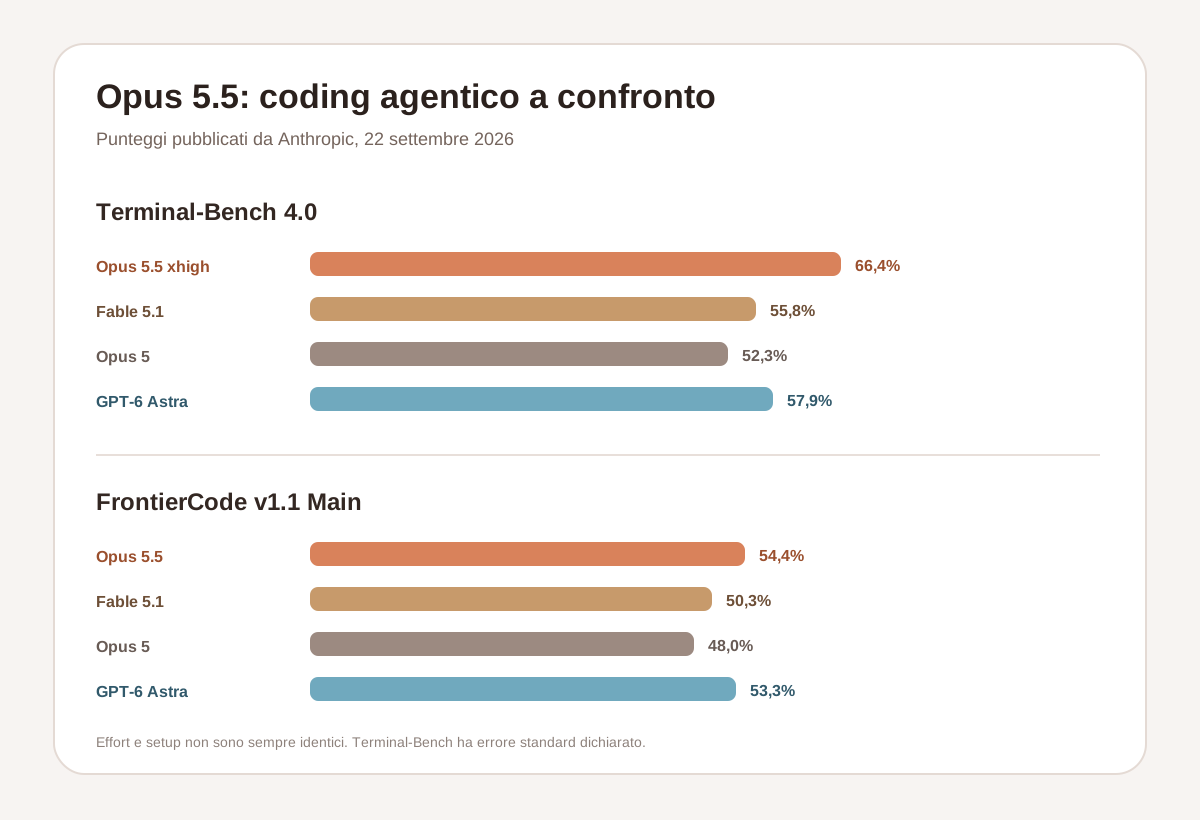
| Coding agentico | 66,4% su Terminal-Bench 4.0 e 57,8% su CursorBench 4.0 nella tabella Anthropic. | 55,8% su Terminal-Bench 4.0 e 51,8% su CursorBench 4.0 nella stessa tabella. |
| Knowledge work e automazioni | 1846 Elo su GDPval-AA v2.1 e 54,4% su FrontierCode. | 1735 Elo su GDPval-AA v2.1 e 50,3% su FrontierCode. |
| Contesto e output | 1M token di contesto, output fino a 128K e thinking adattivo. | 1M token di contesto, output fino a 128K e thinking adattivo sempre attivo. |
| API e conversazioni | Thinking adattivo sempre attivo; tool choice forzato e vecchio computer use richiedono modifiche. | Non supporta forced tool use; i modelli precedenti non possono leggere i suoi thinking block. |
| Retention e safeguards | Non rientra nei Covered Models della classe Mythos. | È un Covered Model; in generale richiede retention dedicata, con accesso ZDR temporaneo per alcune organizzazioni idonee mentre arriva EFS. |
Applicazione
Costi API a confronto
Stime basate sul listino Anthropic verificato il 23 settembre 2026. Gli esempi isolano input, output e cache read; non includono cache write, batch, strumenti esterni o retry.
Analisi senza cache
300K input · 50K output
- Costo con Opus 5.5
- $2,20
- Costo con Fable 5.1
- $5,50
Senza riuso del contesto Fable costa due volte e mezzo Opus 5.5. Deve evitare abbastanza errori, retry o supervisione da recuperare altri $3,30.
Loop con cache moderata
1M cache read · 50K output
- Costo con Opus 5.5
- $1,20
- Costo con Fable 5.1
- $2,75
La cache riduce il costo di entrambi, ma Fable resta più del doppio in questo scenario perché l'output pesa ancora molto.
Agente con cache molto alta
10M cache read · 50K output
- Costo con Opus 5.5
- $3,00
- Costo con Fable 5.1
- $5,00
Anche con molto riuso del contesto Opus 5.5 resta più economico. Vanno aggiunti cache write, input nuovo e retry per conoscere il totale reale.
Cosa cambia con Opus 5.5
Opus 5.5 ribalta il confronto pubblicato a giugno. Anthropic riduce il prezzo da $5/$25 a $4/$20 per milione di token, porta la cache read a $0,20 e mostra punteggi superiori a Fable 5.1 nei principali benchmark del lancio.
- Terminal-Bench 4.0: 66,4% per Opus 5.5 contro 55,8% per Fable 5.1.
- FrontierCode: 54,4% contro 50,3% nella tabella Anthropic.
- CursorBench 4.0: 57,8% contro 51,8%.
- GDPval-AA v2.1: 1846 Elo contro 1735.
- Sono risultati del vendor con effort e setup non sempre identici: indicano cosa testare, non il vincitore universale.
Quando partire da Opus 5.5
Opus 5.5 è il punto di partenza più pratico quando il lavoro è complesso ma verificabile. Costa meno su input, output e cache read e guida i benchmark pubblicati da Anthropic. Fable diventa un'escalation da giustificare con un eval, non la scelta automatica per i task difficili.
- Debug, refactor e migrazioni con test ripetibili.
- Analisi di documenti con output relativamente breve.
- Agenti eseguiti spesso, con o senza riuso della prompt cache.
- Knowledge work in cui servono documenti, analisi o presentazioni verificabili.
- Task in cui un errore è economico da trovare e correggere.
Quando provare Fable 5.1
Fable ha senso soltanto quando un test sul tuo lavoro mostra un vantaggio stabile. Il modello costa due volte e mezzo Opus 5.5 sui token nuovi e non è più favorito nemmeno sulla cache read. Il beneficio deve emergere su completamento, qualità verificata o tempo umano risparmiato.
- Agenti di coding che lavorano per ore su più file e strumenti.
- Ricerca multistep con molte fonti e verifiche successive.
- Documenti, spreadsheet e slide costruiti attraverso numerosi passaggi.
- Workflow nei quali i safeguards e le caratteristiche operative di Fable sono un requisito.
- Task in cui Opus 5.5 ad alto effort continua a fallire negli stessi punti.
La cache cambia il conto, non il listino
Fable 5.1 aveva un vantaggio di cache rispetto a Opus 5, ma Opus 5.5 lo elimina: la cache read costa $0,20 contro $0,25 per milione di token. Input nuovo e output restano a $10 e $50 per Fable, contro $4 e $20 per Opus 5.5.
- Conta separatamente input nuovo, cache write, cache read e output.
- Misura quanta parte del contesto viene davvero letta dalla cache.
- Includi retry, turni aggiuntivi e strumenti esterni.
- Confronta il costo del task completato, non il prezzo di una singola richiesta.
Controlli API prima di scegliere
Entrambi i modelli richiedono attenzione alle conversazioni lunghe. Opus 5.5 usa thinking adattivo sempre attivo e introduce incompatibilità rispetto a Opus 5; Fable 5.1 ha vincoli propri su tool choice e blocchi di ragionamento.
- Rimuovi le configurazioni che disabilitano thinking in Opus 5.5.
- Non usare `tool_choice` forzato: `any` e un tool specifico possono restituire errore.
- Aggiorna il vecchio tool di computer use prima di migrare a Opus 5.5.
- Non aspettarti che Opus o modelli precedenti leggano i thinking block prodotti da Fable 5.1.
- Testa routing e fallback prima di cambiare modello a metà conversazione.
Retention e fallback restano parte della scelta
Fable 5.1 è un Covered Model con safeguards specifici per cybersecurity e biologia. Alcune richieste vengono rifiutate o instradate verso un modello Opus. Anthropic sta introducendo Enterprise Frontier Safeguards per offrire privacy equivalente allo zero data retention, ma il rollout è graduale e non rende ZDR disponibile a tutti.
- Controlla la policy dati del workspace prima di inviare codice o documenti riservati.
- Le organizzazioni idonee possono avere accesso ZDR temporaneo mentre attendono EFS.
- Nei test sensibili, registra quale modello ha prodotto davvero la risposta dopo un fallback.
- Non valutare una risposta instradata a Opus come prova delle prestazioni di Fable.
Un eval che misura la convenienza reale
Prepara da cinque a dieci task rappresentativi e assegna a entrambi i modelli lo stesso contesto, gli stessi strumenti e gli stessi criteri di riuscita. Se il workflow usa cache, misura anche la quota di token letti dalla cache e l'output prodotto.
- Registra costo API totale e costo per task accettato.
- Conta retry, errori non rilevati, test falliti e modifiche scartate.
- Misura il tempo umano di review e correzione.
- Prova più livelli di effort prima di concludere che Opus 5.5 non basta.
- Promuovi Fable solo nei passaggi in cui il vantaggio resta stabile su più task.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Fable 5.1 è migliore di Opus 5.5?
Non nei benchmark pubblicati da Anthropic per il lancio di Opus 5.5. Opus guida Terminal-Bench, FrontierCode, CursorBench e GDPval-AA e costa meno. Fable va provato soltanto se un eval sul tuo workload mostra un vantaggio concreto.
Quanto costa Fable 5.1 rispetto a Opus 5.5?
Fable costa $10 input e $50 output per 1M token, contro $4 e $20 di Opus 5.5. Anche la cache read costa leggermente di più: $0,25 contro $0,20. Il confronto corretto resta il costo per task accettato.
Quale modello usare in Claude Code?
Parti da Opus 5.5 per repository difficili, refactor e agenti di coding. Prova Fable 5.1 solo sui task in cui Opus continua a fallire e mantienilo se gli eval mostrano più completamenti o meno supervisione.
Fable 5.1 è incluso in Claude Pro?
No. Su Pro e Team Standard Fable 5.1 usa crediti a consumo fin dalla prima richiesta. Su Max e posti Premium è incluso fino al 50% del limite settimanale condiviso.
Fable 5.1 può essere usato con Zero Data Retention?
Non in modo generale. È un Covered Model e normalmente richiede una configurazione di retention. Anthropic offre accesso ZDR temporaneo ad alcune organizzazioni idonee mentre introduce Enterprise Frontier Safeguards; la disponibilità va verificata con l'account team.
Posso passare da Opus 5 a Opus 5.5 cambiando solo il model ID?
Non sempre. Thinking sempre attivo, tool choice, computer use e gestione dei blocchi di ragionamento possono richiedere modifiche. Controlla la guida di migrazione e prova conversazioni lunghe e tool call prima del rilascio.
Prossime letture