Gemini 4 Argon batte davvero GPT-6 Astra e Fable?
Il nuovo modello di punta Google contro GPT-6 Astra, Fable 5.1 e Opus 5.5: dove vince nella tabella ufficiale, dove resta dietro, quanto costerà e quando potrai usarlo
Entra nell'analisi
Risposta breve
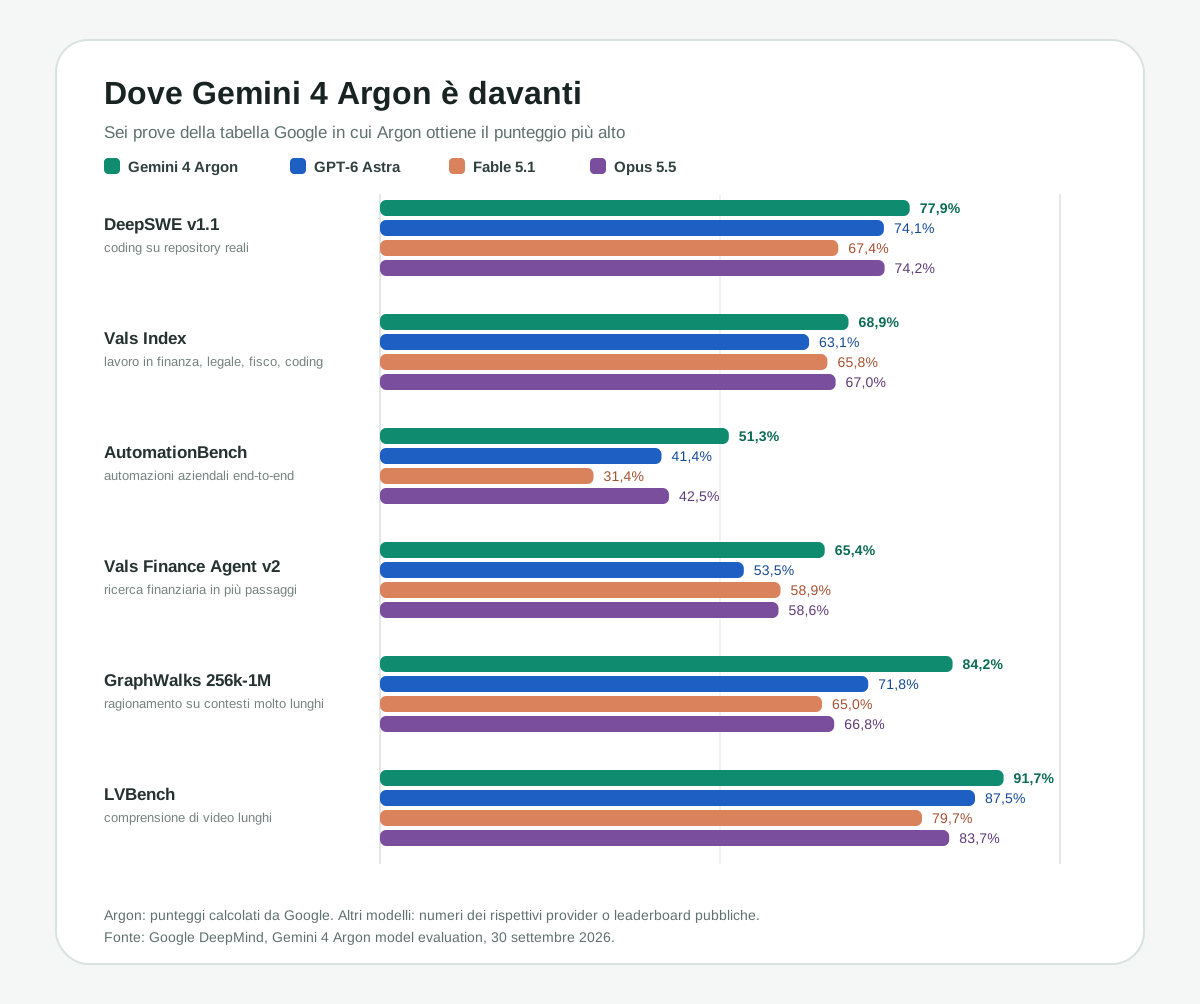
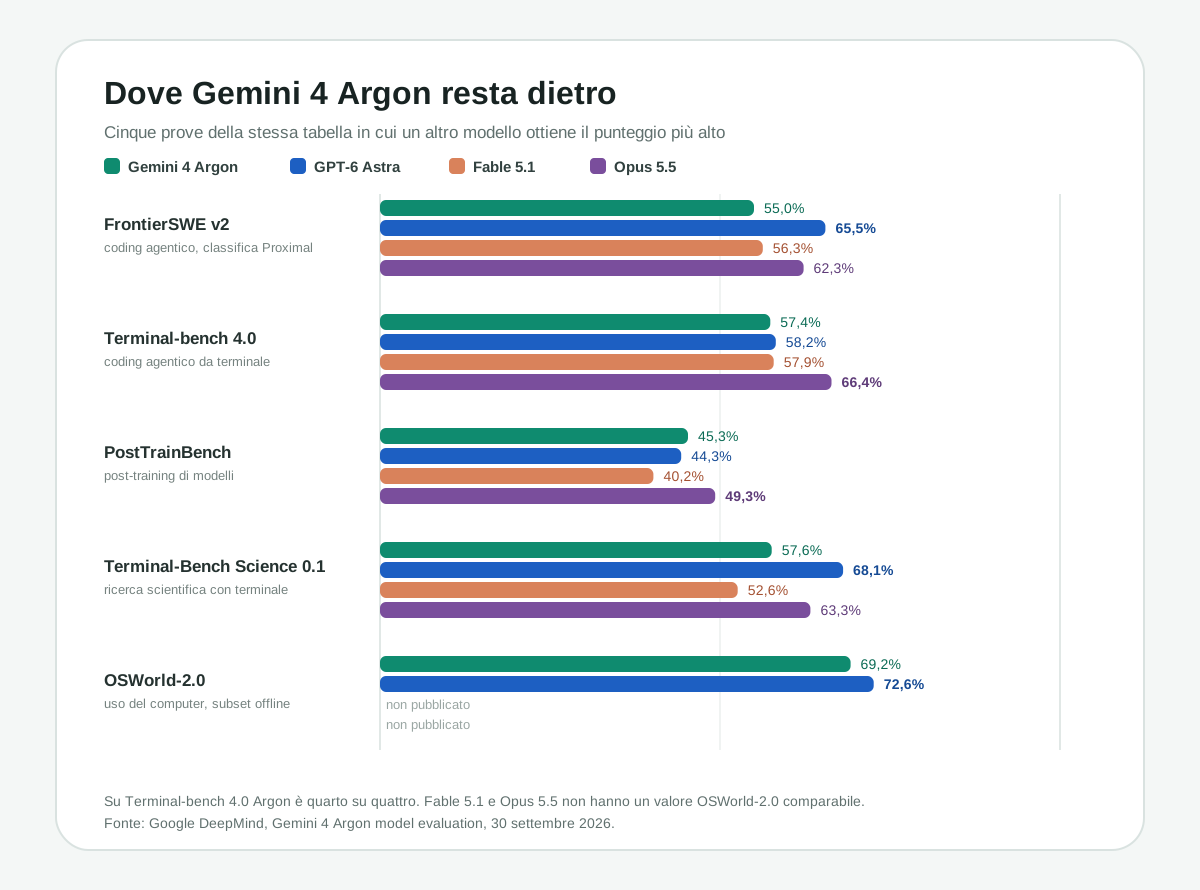
In parte sì. Nella tabella ufficiale Google, Gemini 4 Argon supera Fable 5.1 in 15 prove su 17 e GPT-6 Astra in 14 su 19, con vantaggi netti su lavoro d'ufficio, contesti lunghi e video. Resta dietro ad Astra o a Opus 5.5 su Terminal-bench 4.0, FrontierSWE v2 e Terminal-Bench Science. Sono numeri pubblicati da Google e il modello non è ancora disponibile al pubblico.
- Annunciato il 30 settembre 2026, oggi è accessibile solo tramite il programma Fairwind per la difesa informatica.
- Il rilascio successivo partirà dai clienti API a pagamento e dagli abbonati Google AI Ultra, senza una data ufficiale.
- Prezzo di lancio: $2 input e $10 output per 1M token, poi $4 e $20.
- Su Terminal-bench 4.0 Argon segna 57,4%: è quarto su quattro, dietro anche a Fable 5.1.
- Il limite di output sale a 1M token, contro i 64K del modello precedente.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Risultati nella tabella Google | Come leggerli |
|---|---|---|
| Contro Fable 5.1 | Argon è davanti in 15 prove su 17. Fable vince solo FrontierSWE v2 (56,3% contro 55,0%) e Terminal-bench 4.0 (57,9% contro 57,4%). | È il confronto in cui il titolo regge di più. Considera però che Opus 5.5, più economico, supera già Fable 5.1 in molte prove Anthropic. |
| Contro GPT-6 Astra | Argon è davanti in 14 prove su 19, pari su CWE-bench v1 (68,0%) e dietro in 4: FrontierSWE v2, Terminal-bench 4.0, Terminal-Bench Science e OSWorld-2.0. | Astra resta più forte nei task lunghi da terminale e nell'uso del computer. Argon vince su lavoro d'ufficio, video e contesti lunghi. |
| Contro Opus 5.5 | Argon è davanti in 14 prove su 18. Opus 5.5 vince FrontierSWE v2, Terminal-bench 4.0 (66,4% contro 57,4%), PostTrainBench e Terminal-Bench Science. | Se usi Claude per agenti di coding da terminale, Opus 5.5 ha il dato più forte della tabella. Argon parte meglio su documenti, finanza e legale. |
| DeepSWE v1.1 | Argon 77,9%, Opus 5.5 74,2%, Astra 74,1%, Fable 5.1 67,4%. | È il risultato di coding che Google mette in primo piano. Il punteggio di Argon è calcolato da Google con un proprio harness, quelli degli altri vengono da leaderboard e system card. |
| Lavoro d'ufficio e settori regolati | Vals Index 68,9%, AutomationBench 51,3%, Vals Finance Agent v2 65,4%, Harvey Legal Agent 19,6%: Argon è primo in tutte e quattro. | Sono i vantaggi più ampi e quelli misurati da terzi (Vals AI e Zapier). Su Harvey, però, tutti i modelli restano sotto il 20%: usali come supporto alla ricerca legale, non al posto della revisione di un professionista. |
| Contesti lunghi e video | GraphWalks 256k-1M: Argon 84,2%, Astra 71,8%. LVBench: Argon 91,7%, Astra 87,5%. | Se lavori su archivi molto lunghi o video, è il vantaggio più concreto. Su LVBench, però, ogni modello ha ricevuto un numero di fotogrammi diverso per limiti delle API. |
| Sicurezza informatica | CWE-bench v1: Argon e Astra 68,0%, Opus 5.5 67,0%, Fable 5.1 58,0%. | È un pareggio, non un sorpasso. I benchmark interni di Google sulla scoperta di vulnerabilità confrontano Argon solo con i modelli Google precedenti. |
Applicazione
Quanto costerà rispetto agli altri modelli
Gli esempi usano il prezzo API annunciato da Google per Argon e i listini ufficiali di OpenAI e Anthropic già verificati su QualeAI. Google non ha indicato quando finirà il prezzo di lancio, quindi conviene stimare i costi con entrambi i listini.
Task API medio
100.000 token input · 20.000 token output
- Scenario
- Argon: $0,40 al prezzo di lancio, $0,80 dopo
- Cosa cambia per te
- Astra o Fable 5.1: $2,00. Opus 5.5: $0,80
Al prezzo di lancio Argon costa un quinto di Astra e Fable. Finito il lancio costa quanto Opus 5.5: il confronto si sposta su qualità e affidabilità sul tuo lavoro.
Output molto lungo
200.000 token input · 1.000.000 token output
- Scenario
- Argon: $10,40 al lancio, $20,80 dopo
- Cosa cambia per te
- Astra: oltre il suo limite di 128K token di output per richiesta
Il limite di 1M token di output è una novità reale, ma un'unica risposta così lunga costa quanto circa 25 task medi come quello sopra. Usalo per migrazioni o analisi in un solo passaggio, non come impostazione predefinita.
Contesto ripetuto con cache
1M token input letti dalla cache · Sconto sull'input
- Scenario
- Argon: $0,10 al lancio, $0,20 dopo
- Cosa cambia per te
- Opus 5.5: $0,20. Fable 5.1: $0,25
Google applica uno sconto del 95% sui token in cache. Se rileggi spesso lo stesso repository o gli stessi documenti, il costo dell'input diventa marginale.
Che cos'è Gemini 4 Argon
Gemini 4 Argon è il modello di frontiera di Google DeepMind annunciato il 30 settembre 2026. Google lo presenta come il suo modello più forte per lo sviluppo software su progetti lunghi, il lavoro d'ufficio in ambiti come finanza e legale e la difesa informatica. La novità tecnica più visibile è il limite di output, che sale da 64K a 1M token: il modello può produrre in una sola risposta un volume di testo o codice che prima richiedeva molte richieste separate.
- Google lo usa già internamente per migrare codice C e C++ verso Rust e ottimizzare l'uso della memoria nei data center.
- L'annuncio non indica ancora il nome del modello nell'API né la finestra di contesto in input.
Perché non puoi ancora provarlo
Argon è oggi disponibile solo per un gruppo di esperti di sicurezza informatica selezionati tramite il programma Fairwind di Google. Per loro il modello viene rilasciato senza le protezioni che normalmente limitano le richieste in ambito cyber. Google partecipa anche al processo volontario del governo statunitense per l'accesso anticipato ai modelli. Il rilascio successivo partirà dai clienti API a pagamento e dagli abbonati Google AI Ultra, ma Google non ha indicato una data.
- In Italia Google AI Ultra parte da 99,99 euro al mese: non abbonarti solo per Argon prima che sia confermato il rilascio nel piano.
- Non pianificare migrazioni con una data finché Argon non compare nell'API o nell'app Gemini del tuo account.
- Fino ad allora, per lavorare con Google usa i modelli Gemini già disponibili, come Gemini 3.8 Flash.
Chi ha misurato cosa
Prima di leggere i numeri, conta capire da dove arrivano. Google ha calcolato da sé i punteggi di Argon su prove come DeepSWE, Terminal-bench 4.0, Terminal-Bench Science, LVBench e OSWorld. In quelle righe i punteggi degli altri modelli arrivano dalle dichiarazioni dei provider o da leaderboard pubbliche. Su PostTrainBench, LABBench 2 e GraphWalks Google ha misurato tutti i modelli con il proprio setup. Altre righe, come Vals Index, AutomationBench, Vibe Code Bench, FrontierSWE e CWE-bench, provengono interamente da classifiche gestite da terzi.
- Su Terminal-Bench Science Google ha dato ad Argon un tempo di verifica sei volte più lungo per evitare errori di timeout.
- Su OSWorld-2.0 il punteggio di Argon è il migliore di tre esecuzioni.
- Su LVBench Argon legge il video a 1 fotogramma al secondo, mentre gli altri modelli hanno ricevuto da 300 a 800 fotogrammi per limiti delle API.
- Alcuni numeri non coincidono con quelli della tabella OpenAI al lancio di Astra: su Terminal-bench 4.0 OpenAI riportava 57,7% per Astra e 55,8% per Fable 5.1, qui diventano 58,2% e 57,9% perché arrivano dalla leaderboard pubblica.
Dove Argon convince di più
I vantaggi più solidi sono quelli misurati da terzi e con margini ampi: AutomationBench di Zapier (51,3% contro 42,5% del secondo), Vals Finance Agent v2 (65,4% contro 58,9%) e Harvey Legal Agent (19,6% contro 6,7%). Anche sui contesti tra 256K e 1M token il distacco supera i 12 punti, in una prova che Google ha misurato su tutti i modelli. Se il tuo lavoro è analizzare documenti lunghi, automatizzare processi aziendali o fare ricerca finanziaria, Argon è il modello da mettere in lista per il primo test.
- Su DeepSWE v1.1 il vantaggio è reale ma più stretto: 3,7 punti su Opus 5.5.
- Su Vibe Code Bench i quattro modelli stanno tra 89,6% e 91,9%: una differenza troppo piccola per guidare la scelta.
- Su LABBench 2 e RiemannBench, ricerca biologica e matematica, Argon è primo con margini di 3-4 punti su Astra.
Dove i dati non reggono il titolo
Se usi agenti di coding che lavorano a lungo da terminale, la tabella Google non dà ragioni per cambiare. Su Terminal-bench 4.0 Argon è ultimo dei quattro con 57,4%, mentre Opus 5.5 arriva a 66,4%. Su FrontierSWE v2, un'altra prova di coding agentico con classifica gestita da Proximal, Argon segna 55,0% contro 65,5% di Astra. Anche nella ricerca scientifica con terminale Astra è davanti di oltre 10 punti.
- Per agenti di coding da terminale, Opus 5.5 e Astra restano i riferimenti nella stessa tabella pubblicata da Google.
- Su OSWorld-2.0, uso del computer, Astra segna 72,6% contro 69,2% di Argon.
- Su PostTrainBench, addestramento di modelli, Opus 5.5 è davanti con 49,3% contro 45,3%.
Cosa fare oggi se stai scegliendo un modello
Argon non cambia le scelte che puoi fare questa settimana, perché non puoi ancora usarlo. Può però cambiare cosa misurare. Prepara ora un set di task reali per il confronto, così quando il modello arriva nell'API o nel tuo piano puoi provarlo in un giorno invece di fidarti dei grafici. Se il tuo lavoro somiglia alle prove in cui Argon vince, il test vale la pena. Se il tuo lavoro è soprattutto coding da terminale, resta sul modello che usi.
- Scegli 5-10 task per ogni tipo di lavoro importante, con un criterio chiaro di riuscita.
- Registra costo, tempo, numero di tentativi e minuti di revisione con il modello attuale.
- Quando Argon arriva, ripeti gli stessi task con gli stessi strumenti e confronta il costo per task riuscito.
- Stima i costi anche al prezzo pieno di $4/$20: il prezzo di lancio non è garantito nel tempo.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Gemini 4 Argon è più potente di GPT-6 Astra?
Nella tabella pubblicata da Google è davanti in 14 prove su 19, pari in una e dietro in 4. Astra resta più forte su FrontierSWE v2, Terminal-bench 4.0, Terminal-Bench Science e OSWorld-2.0. I punteggi di Argon sono calcolati da Google e non ancora verificati in modo indipendente.
Gemini 4 Argon è meglio di Claude Fable 5.1?
Nei numeri pubblicati da Google sì, quasi ovunque: Argon è davanti in 15 prove su 17. Fable vince di poco solo FrontierSWE v2 e Terminal-bench 4.0. Il concorrente Anthropic più vicino nella tabella è però Opus 5.5, che vince 4 prove su 18.
Quando potrò usare Gemini 4 Argon in Italia?
Google non ha indicato una data. Oggi Argon è riservato al programma Fairwind per la difesa informatica. Il rilascio successivo partirà dai clienti API a pagamento e dagli abbonati Google AI Ultra, poi arriverà a sviluppatori, aziende e consumatori. Non sono stati annunciati limiti specifici per l'Italia.
Quanto costa Gemini 4 Argon?
Nell'API costerà $2 per 1M token input e $10 per 1M token output al prezzo di lancio, con uno sconto del 95% sui token in cache. Finito il periodo di lancio il prezzo sale a $4 e $20, come Opus 5.5. Google non ha indicato la durata del periodo di lancio.
Cosa significa il limite di output di 1M token?
Il modello può generare fino a un milione di token in una sola risposta, contro i 64K del modello Google precedente. Serve per migrazioni di codice o analisi molto lunghe in un solo passaggio. Ha un costo: una risposta da 1M token costa $10 al prezzo di lancio e $20 dopo.
Prossime letture