Qwen4-Max: cos'è, benchmark, prezzi e confronto
Alibaba lo vende a una frazione del prezzo di Claude e GPT: dove regge il confronto e dove resta indietro
Entra nell'analisi
Risposta breve
Qwen4-Max è il nuovo modello di punta di Alibaba, uscito il 16 novembre 2026. Costa $1,50 e $4,50 per milione di token, ma nella classifica indipendente sta sotto Claude, GPT, Gemini e Kimi K3.1 Pro. Provalo per agenti su compiti lunghi e per API che rileggono spesso lo stesso contesto; per il codice difficile e per la qualità generale restano più forti i modelli americani.
- Agenti su compiti lunghi con strumenti: vale una prova, nei test Alibaba è davanti a Claude Opus 5.5 su Agents' Last Exam.
- Codice da terminale: Kimi K3.1, Claude Opus e GPT restano avanti di molto; nella ricostruzione di un software intero sono avanti Opus e GPT.
- API con lo stesso contesto ripetuto: la cache costa $0,075 per milione di token, ma confronta il costo per compito con Gemini 4 Hydrogen e GPT-6.2 Sol.
- Modello da eseguire sul tuo computer: Qwen4-Max non lo è, i pesi non sono pubblici.
Differenze
Il confronto che orienta la scelta
| Criterio | Cosa dicono i dati | Cosa cambia nella scelta |
|---|---|---|
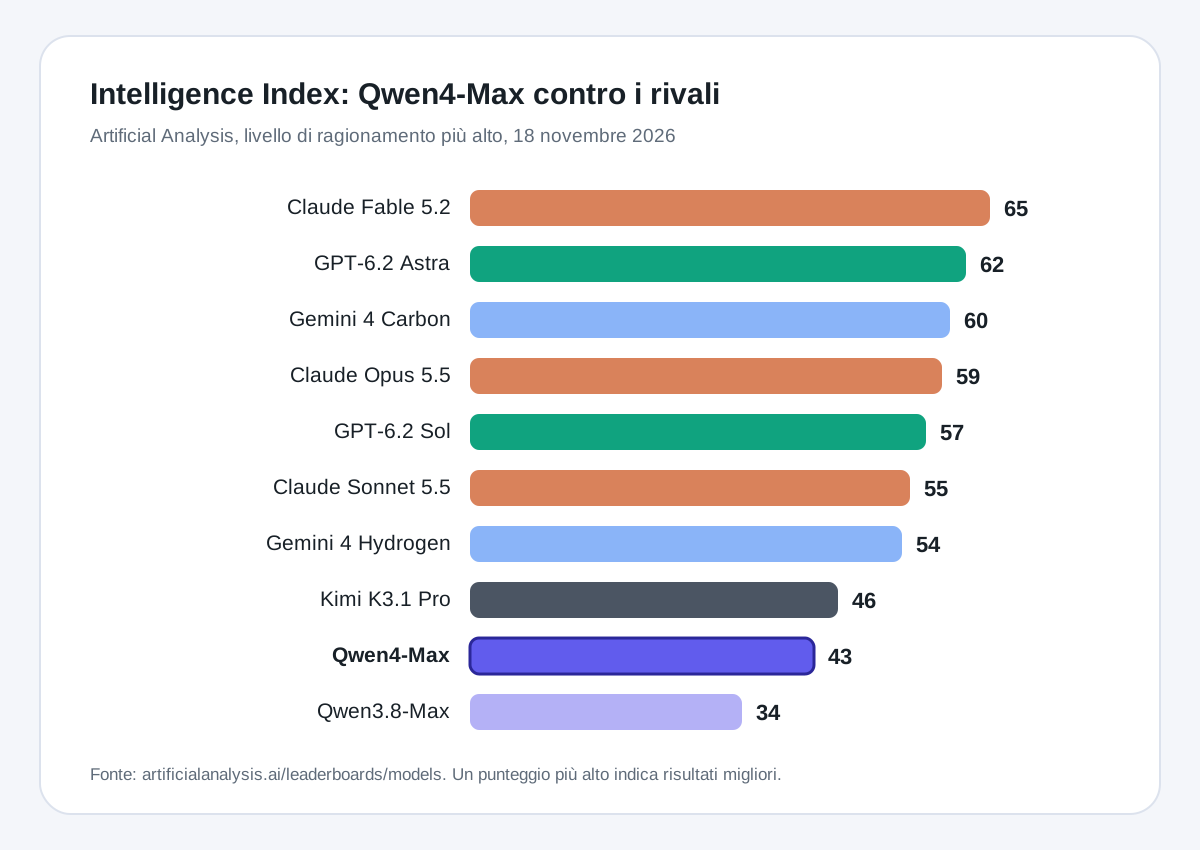
| Classifica indipendente | Artificial Analysis: Qwen4-Max 43, Kimi K3.1 Pro 46, Gemini 4 Hydrogen 54, GPT-6.2 Sol 57, Claude Opus 5.5 59, Claude Fable 5.2 65. | È il secondo modello cinese della classifica, dietro Kimi. Rispetto ai modelli di punta americani c'è una fascia intera di distanza. |
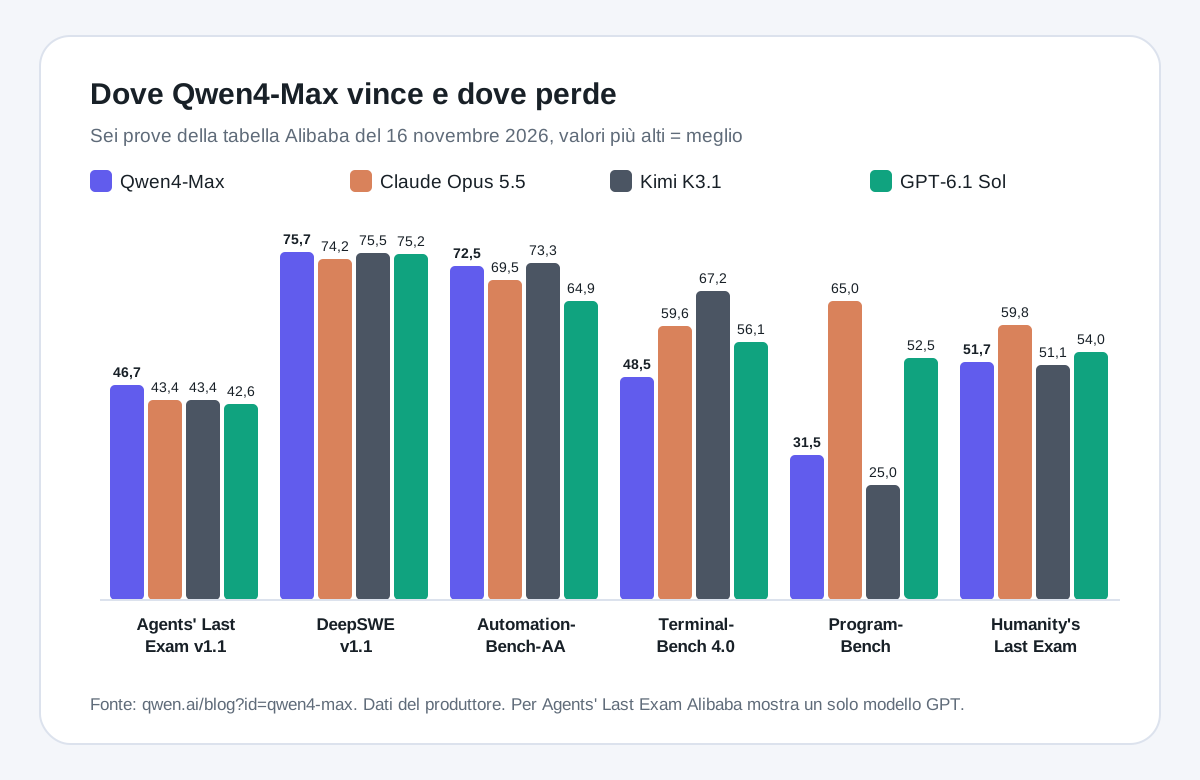
| Agenti e lavoro d'ufficio | Tabella Alibaba: Agents' Last Exam 46,7 contro 43,4 di Opus 5.5 e Kimi K3.1; JobBench 68,5 contro 75,4 di Opus; AA-Briefcase 1686 contro 1801 di Opus. | Sui compiti lunghi con strumenti è competitivo. Su documenti e lavoro professionale Opus resta davanti. Dati del produttore. |
| Codice | Tabella Alibaba: DeepSWE 75,7, alla pari con tutti; Terminal-Bench 4.0 48,5 contro 67,2 di Kimi K3.1 e 59,6 di Opus; ProgramBench 31,5 contro 65 di Opus. | Va bene per correggere singoli bug. Da terminale è nettamente dietro; nella ricostruzione di un software intero è dietro Opus e GPT ma davanti a Kimi (25). |
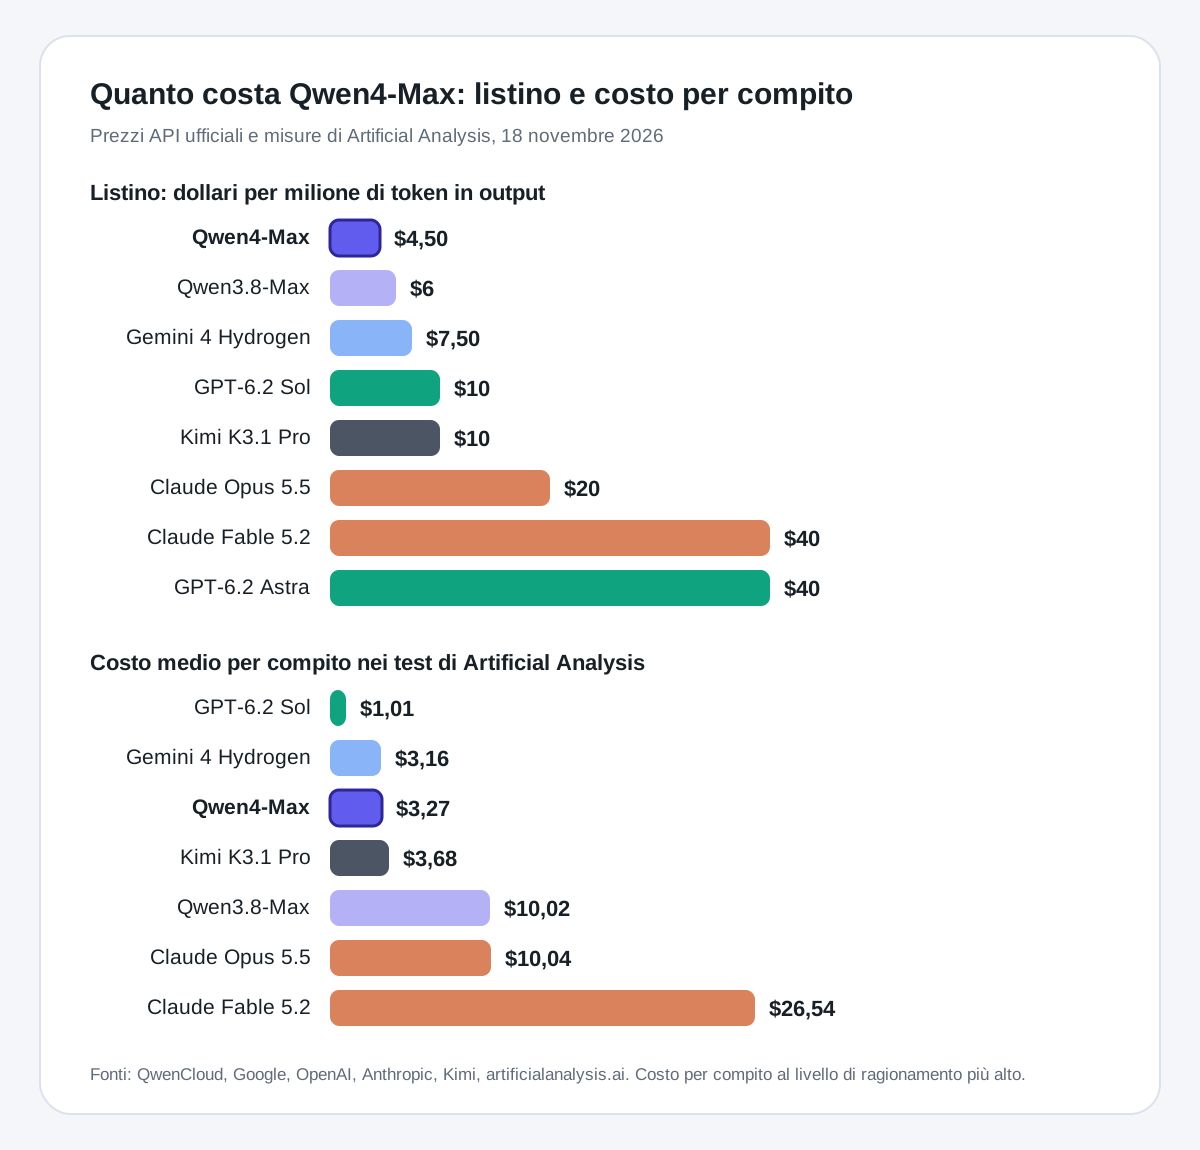
| Prezzo API | $1,50 input e $4,50 output per 1M token; input in cache $0,075. Gemini 4 Hydrogen $1,50/$7,50, GPT-6.2 Sol e Kimi K3.1 Pro $2/$10, Opus 5.5 $4/$20, Fable 5.2 $8/$40. | Ha l'output più economico tra i modelli confrontati. Per compito però Artificial Analysis lo misura a $3,27, contro $3,16 di Hydrogen e $1,01 di GPT-6.2 Sol, che hanno punteggi più alti. |
| Pesi aperti | Qwen4-Max ha pesi chiusi. Alibaba annuncia modelli Qwen4 più piccoli a pesi aperti, senza una data. | Non puoi scaricarlo né eseguirlo in locale. Per un Qwen sul tuo computer oggi restano i modelli Qwen3.8 a pesi aperti. |
| Dove si usa | API e Token Plan su QwenCloud, Qwen Studio (chat.qwen.ai), QwenWork e Qoder. | Alibaba lo indica in Qwen Studio. Il 18 novembre, senza account, il menu mostrava ancora Qwen3.7-Plus e Qwen3.8-Max. |
Applicazione
Quanto costa lo stesso lavoro nell'API
I conti usano i listini ufficiali per milione di token, regione Singapore per Qwen, senza imposte e senza sconti batch. Il listino da solo però non basta: conta quanti token il modello genera e quante volte serve ripetere il compito.
Documento lungo con riassunto
200.000 token input · 20.000 token output
- Scenario
- Qwen4-Max: $0,39
- Costo stimato
- Gemini 4 Hydrogen: $0,45; GPT-6.2 Sol o Kimi K3.1 Pro: $0,60; Opus 5.5: $1,20
A parità di token Qwen costa un po' meno di Hydrogen, circa un terzo meno di Sol e Kimi e un terzo di Opus. Vale se la qualità del riassunto ti basta al primo tentativo.
Stesso contesto riletto più volte
100.000 token di contesto in 50 richieste · Output escluso
- Scenario
- Senza cache: $7,50
- Costo stimato
- Con cache attiva: circa $0,56
Se un assistente o un agente rilegge sempre lo stesso manuale o repository, la cache abbassa il costo dell'input di oltre dieci volte. Le richieste devono arrivare entro la durata della cache scelta.
Compito misurato da Artificial Analysis
Stessa batteria di test · Token reali usati da ogni modello
- Scenario
- Qwen4-Max: $3,27
- Costo stimato
- GPT-6.2 Sol: $1,01; Gemini 4 Hydrogen: $3,16; Kimi K3.1 Pro: $3,68; Opus 5.5: $10,04
Qwen ragiona a lungo e genera molti token: per compito costa tre volte GPT-6.2 Sol e poco più di Hydrogen, che nella stessa classifica hanno 14 e 11 punti in più.
Che cos'è Qwen4-Max
Qwen4-Max è il primo modello della generazione Qwen4 di Alibaba e sostituisce Qwen3.8-Max. È uscito il 16 novembre 2026, dopo un'anteprima di pochi giorni partita l'11 novembre. Alibaba lo presenta come un collega digitale per lavori lunghi: progetti di codice, analisi di documenti, ricerca e automazioni con molti strumenti.
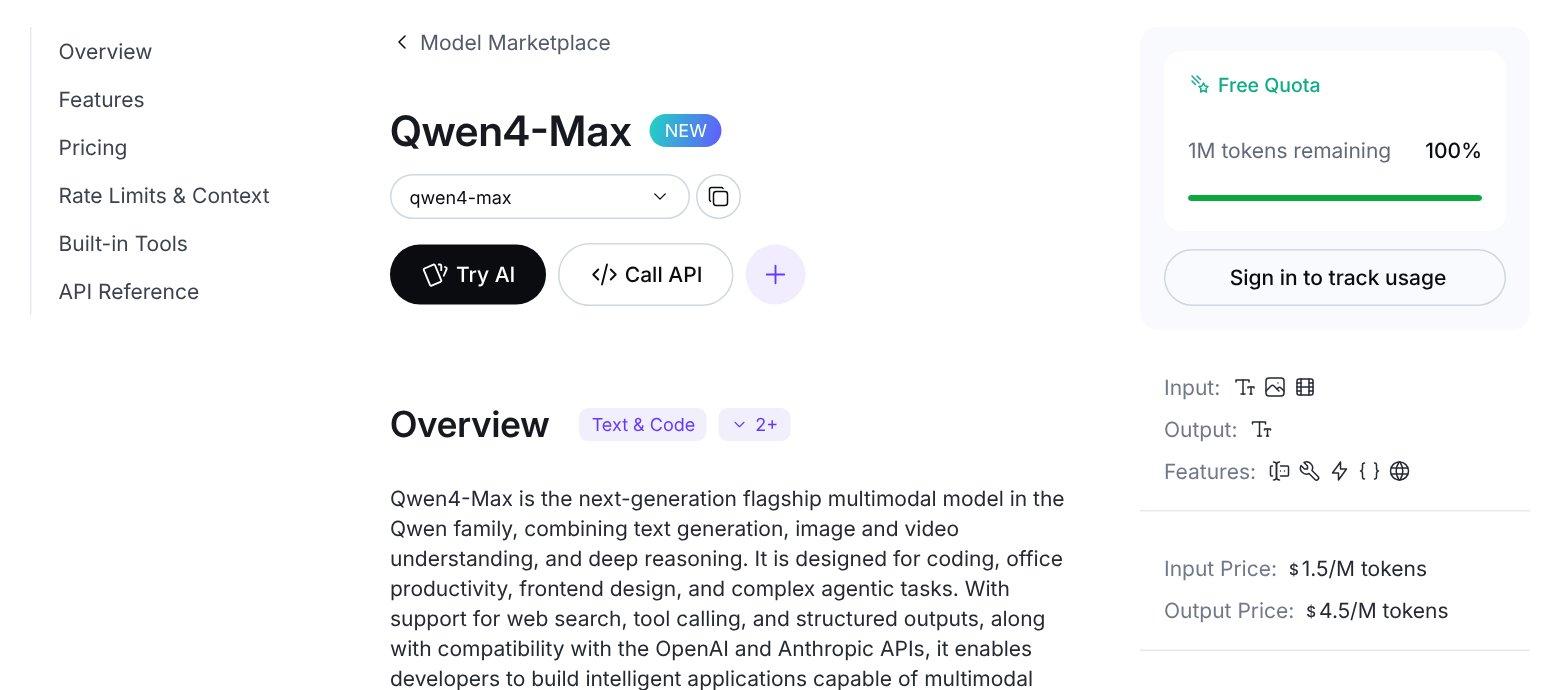
- Architettura Mixture-of-Experts da 2,4 trilioni di parametri, con 71 miliardi attivi per ogni token: un quarto in meno di Qwen3.8-Max.
- Contesto fino a 1 milione di token; legge testo, immagini e video e risponde in testo.
- Tre livelli di ragionamento nell'API: low, high (predefinito) e xhigh.
Contro Claude, GPT e Kimi: la classifica indipendente
Artificial Analysis mette alla prova tutti i modelli con la stessa batteria di test. Qwen4-Max fa 43: nove punti più di Qwen3.8-Max, che si fermava a 34. Resta però tre punti sotto Kimi K3.1 Pro, l'altro modello cinese di punta, e lontano dai migliori modelli americani: Gemini 4 Hydrogen fa 54, GPT-6.2 Sol 57, Claude Opus 5.5 59 e Claude Fable 5.2 65.
Dove vince e dove perde nei test di Alibaba
Nella tabella pubblicata al lancio Alibaba confronta Qwen4-Max con Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Kimi K3.1. Qwen è primo su Agents' Last Exam, che misura compiti lunghi e di valore economico, ed è alla pari su DeepSWE, che misura la correzione di bug. Perde invece di molto nel lavoro da terminale, dove Kimi K3.1 è il più forte, e nella ricostruzione di un software intero, dove Opus e GPT sono molto avanti. I modelli GPT della tabella sono quelli precedenti a GPT-6.2, uscito il 17 novembre.
Quanto costa davvero
Qwen4-Max costa $1,50 per milione di token in input e $4,50 in output, un quarto in meno di Qwen3.8-Max. In output è il più economico tra i modelli confrontati: Gemini 4 Hydrogen costa $1,50 e $7,50, GPT-6.2 Sol e Kimi K3.1 Pro $2 e $10, Claude Opus 5.5 $4 e $20. Sul costo per compito il quadro cambia: Artificial Analysis lo misura a $3,27, poco meno di Kimi, poco più di Hydrogen e più del triplo di GPT-6.2 Sol, perché Qwen ragiona a lungo e genera molti token.
- Confronta il costo per compito riuscito, non solo il listino per token.
- Parti dal livello high e passa a xhigh solo dove il risultato cambia: nei test Alibaba sul terminale il salto è grande.
Quando conviene un'alternativa economica a Claude, GPT e Gemini
Si può usare in locale?
No. A differenza della generazione precedente, in cui anche il modello più grande aveva i pesi pubblici, Qwen4-Max si usa solo attraverso i servizi di Alibaba. Alibaba dice che i modelli Qwen4 più piccoli arriveranno a pesi aperti, ma non ha dato una data. Se ti serve un Qwen da eseguire sul tuo computer, oggi la scelta resta tra i modelli Qwen3.8 a pesi aperti, come il 27B.
- Usando Qwen4-Max nel cloud i tuoi dati passano dai server di Alibaba: controlla regione e condizioni prima di inviare dati personali o aziendali.
- Per un uso in locale con un agente che esegue comandi, isola il computer dalla rete.
Usare Qwen in locale con tranquillità: cosa è successo e le precauzioni
Quando provarlo e quando restare dove sei
Qwen4-Max ha senso se paghi molte chiamate API per agenti, automazioni o analisi di documenti e puoi misurare il risultato: l'output economico e la cache a basso prezzo abbassano la bolletta, a patto che il modello chiuda il compito senza troppi tentativi. Se usi un assistente in chat per il lavoro di ogni giorno, non c'è un motivo concreto per cambiare. Se scrivi codice in un terminale o lavori su progetti grandi, Claude, Kimi e GPT oggi fanno meglio. Se cerchi soprattutto il miglior rapporto tra qualità e costo per compito, prova prima Gemini 4 Hydrogen e GPT-6.2 Sol.
- Fai una prova su 10-20 compiti già risolti, con lo stesso budget per tutti i modelli.
- Se vince solo sul prezzo ma richiede più correzioni, usalo come modello secondario per i compiti a rischio basso.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Qwen4-Max è gratis?
Nell'API no: costa $1,50 per milione di token in input e $4,50 in output, con 1 milione di token gratuiti per 90 giorni sui nuovi account della regione Singapore. Alibaba lo indica anche in Qwen Studio, l'assistente in chat, ma non pubblica i limiti d'uso. Il 18 novembre, senza account, il menu di Qwen Studio mostrava ancora Qwen3.8-Max.
Qwen4-Max è meglio di Claude o ChatGPT?
Nella classifica indipendente di Artificial Analysis no: fa 43, contro 57 di GPT-6.2 Sol e 59 di Claude Opus 5.5. Nei test Alibaba è avanti su alcuni compiti lunghi con strumenti, ma resta dietro nel codice da terminale e nel ragionamento interdisciplinare.
Meglio Qwen4-Max o Kimi K3.1?
Kimi K3.1 Pro è avanti nella classifica indipendente, 46 contro 43, e molto avanti nel lavoro da terminale nei test Alibaba; Qwen è davanti nella ricostruzione di un software intero. Qwen4-Max costa meno per token, $4,50 contro $10 in output, e nella misura di Artificial Analysis costa anche un po' meno per compito.
Qwen4-Max è open source?
No. I pesi di Qwen4-Max non sono pubblici e non lo puoi scaricare. Alibaba ha annunciato modelli Qwen4 più piccoli a pesi aperti, senza una data.
Che fine ha fatto Qwen3.8-Max?
Qwen4-Max lo sostituisce. Costa meno, $1,50 e $4,50 contro $2 e $6 per milione di token, e nella classifica di Artificial Analysis passa da 34 a 43. Secondo Alibaba usa anche il 24-35% di token in meno sui compiti di lavoro misurati con Work360.
Prossime letture