Jev vs LLM: cos’è e quando conviene usarlo
TypeSafe AI rinuncia alla generazione di testo per restituire scelte, punteggi e probabilità: vantaggi, limiti e casi in cui un LLM resta necessario
Entra nell'analisi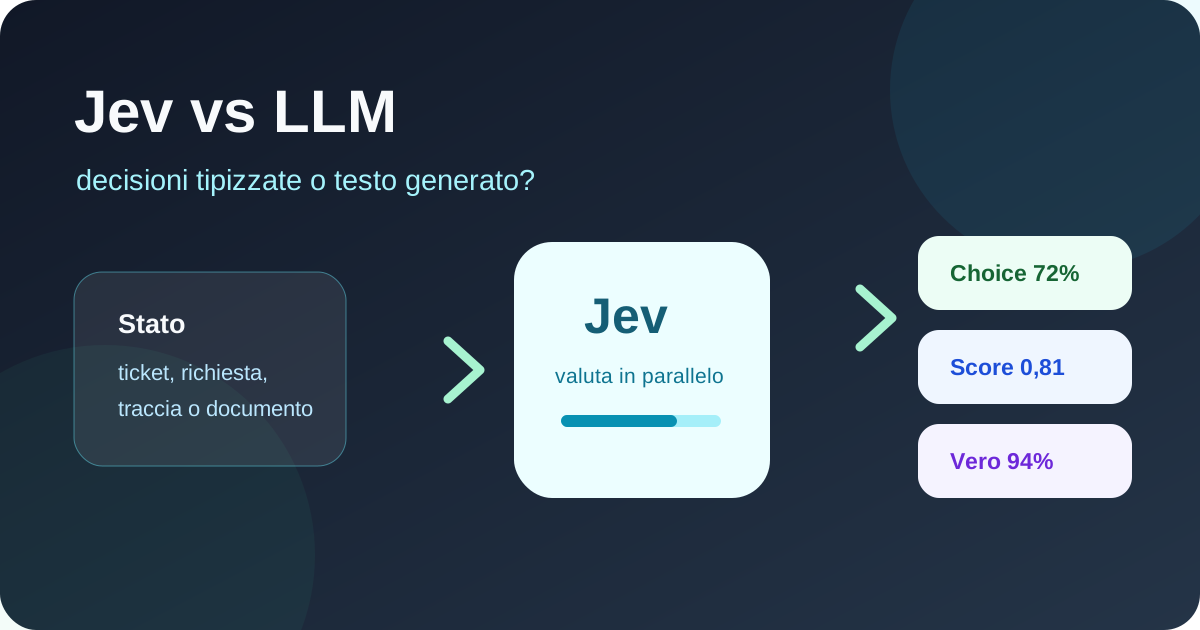
Jev sostituisce gli LLM?
No. Jev è un modello decisionale per domande con risposte già definite: classifica, assegna punteggi e restituisce probabilità che il software può usare subito. Conviene per routing, triage e controlli frequenti. Un LLM resta necessario per scrivere, spiegare, programmare o affrontare problemi aperti. Per calcoli e regole certe, usa invece codice tradizionale.
- Jev comprende input testuali, ma non genera prosa o codice.
- L'output rispetta lo schema; la decisione può comunque essere sbagliata.
- TypeSafe dichiara 70-500 ms per chiamata e $0,042 per milione di token in input.
- È adatto a scelte, punteggi e verifiche con alternative note in anticipo.
- Numeri, date, regole deterministiche e permessi devono restare nel codice.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Jev | LLM generativo |
|---|---|---|
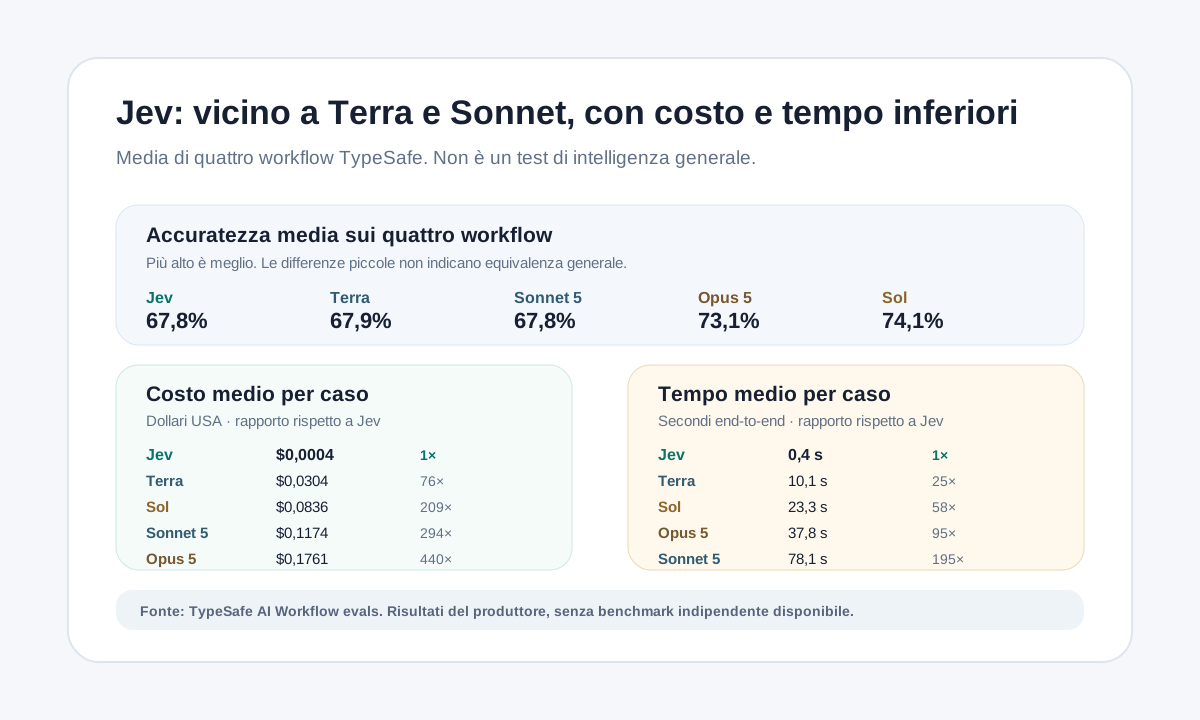
| Accuratezza nelle eval TypeSafe | 67,8% di media sui quattro workflow pubblicati. | Terra 67,9%, Sonnet 5 67,8%, Opus 5 73,1% e Sol 74,1%. Il test riguarda decisioni chiuse, non generazione o ragionamento generale. |
| Costo medio per caso | $0,0004 nella media delle workflow eval TypeSafe. | Da $0,0304 con Terra a $0,1761 con Opus 5 nello stesso harness. Sono costi misurati dal vendor, non preventivi universali. |
| Tempo medio per caso | 0,4 secondi nella media delle workflow eval TypeSafe. | Terra 10,1 s, Sol 23,3 s, Opus 5 37,8 s e Sonnet 5 78,1 s. TypeSafe segnala che le prove sono eseguite in genere dai propri laptop sulla West Coast. |
| Tipo di output | Choice, Score o risposta booleana con probabilità e confidence. | Testo, codice, JSON, immagini o altri contenuti generati token per token. |
| Spazio delle risposte | Deve essere definito prima della chiamata. | Può restare aperto e adattarsi alla richiesta. |
| Uso principale | Classificare, valutare, instradare, filtrare e applicare guardrail. | Scrivere, spiegare, sintetizzare, programmare e risolvere problemi complessi. |
| Validità dell'output | Il tipo è garantito, ma il valore scelto può essere errato. | Lo schema può essere vincolato, ma il contenuto richiede comunque verifica. |
| Incertezza | Restituisce distribuzioni di probabilità e confidence per ogni decisione. | Può restituire log probability o stime richieste nel prompt, non sempre calibrate. |
| Latenza e costo | TypeSafe dichiara 70-500 ms e $0,042 per milione di token input. | Variano molto con modello, reasoning, lunghezza dell'output e provider. |
Applicazione
Quale modello usare nei casi reali
Il prezzo per token racconta solo una parte del costo. Per scegliere misura accuratezza sul tuo dataset, latenza, numero di chiamate, revisioni umane ed errori che arrivano in produzione.
Smistamento ticket
Testo del ticket e categorie consentite · Coda, priorità e probabilità
- Usa Jev
- Jev
- Usa un LLM
- LLM solo per casi ambigui
Jev può gestire il primo passaggio; manda a un LLM o a una persona i ticket sotto la soglia di confidenza.
Risposta al cliente
Cronologia, policy e tono · Messaggio completo e motivato
- Usa Jev
- LLM generativo
- Usa un LLM
- Jev come controllo
Un LLM scrive la risposta. Jev può valutarne tono, conformità o rischio prima dell'invio.
Limite di rimborso
Importo, data e policy deterministica · Esito esatto
- Usa Jev
- Codice tradizionale
- Usa un LLM
- Nessun modello necessario
Se la regola può essere calcolata senza ambiguità, il codice è più affidabile di Jev e di un LLM.
Routing tra modelli
Richiesta, rischio e complessità stimata · Modello o workflow da chiamare
- Usa Jev
- Jev per la decisione
- Usa un LLM
- LLM per l'esecuzione
Il risparmio esiste solo se il router sceglie bene e costa meno delle chiamate premium che evita.
Che cos'è Jev
Jev è il primo modello pubblico di TypeSafe AI, disponibile dal 15 settembre 2026. L'azienda lo definisce System One model: riceve uno stato testuale o strutturato e valuta domande con risposte stabilite in anticipo. Invece di comporre una frase, restituisce direttamente scelte, punteggi o probabilità booleane che il software può leggere senza estrarre una decisione dalla prosa.
- Choice sceglie fra opzioni definite e restituisce la distribuzione delle probabilità.
- Score valuta l'input su una scala ordinata.
- Noul, il tipo booleano di TypeSafe, restituisce la probabilità che un'affermazione sia vera.
- Più domande sullo stesso stato vengono valutate in parallelo.
- L'input attuale è testuale; immagini, audio e video non sono supportati.
Perché se ne parla tanto
Jev propone un'interfaccia diversa dal chatbot: una funzione intelligente che il codice può chiamare molte volte dentro un workflow. TypeSafe dichiara che, sui propri task System One, il modello può essere fino a 193,6 volte più veloce e 444,6 volte più economico degli LLM confrontati. Il lancio ha attirato attenzione anche perché Vercel e LangChain hanno pubblicato integrazioni nei giorni successivi.
- Il listino dichiarato è $0,042 per milione di token input, senza costo misurabile per l'output.
- La latenza dichiarata è compresa fra 70 e 500 millisecondi.
- Vercel AI Gateway espone Jev tramite l'API evaluate.
- LangChain lo integra per classificazione, routing e controlli sui tool.
- L'accesso diretto TypeSafe è ancora in early access; Vercel offre un percorso tramite AI Gateway.
- I moltiplicatori massimi provengono da eval di TypeSafe e non vanno letti come risultato garantito su ogni workload.
- Le workflow eval ufficiali usano come riferimento la media delle risposte di GPT-6 Astra e Fable 5.1, non una ground truth indipendente.
Cosa dicono davvero i benchmark sull'intelligenza
Nel riepilogo delle quattro workflow eval pubblicate da TypeSafe, Jev raggiunge il 67,8% di accuratezza media. È quasi alla pari con GPT-5.6 Terra al 67,9% e con Claude Sonnet 5 al 67,8%, mentre GPT-5.6 Sol sale al 74,1% e Claude Opus 5 al 73,1%. Sullo stesso harness, Jev registra $0,0004 e 0,4 secondi per caso: il vantaggio più netto è quindi nell'efficienza, non in una superiorità assoluta di accuratezza.
- Le quattro prove coprono incidenti di sicurezza, osservabilità di agenti, fatture e assistenza clienti.
- Ogni modello esegue lo stesso workflow strutturato; TypeSafe confronta anche prompt standalone, che risultano meno accurati.
- Le etichette di riferimento derivano dalla media delle risposte di GPT-6 Astra e Fable 5.1 ad alto reasoning, non da una ground truth indipendente.
- Il benchmark non misura scrittura, coding, sintesi, uso di strumenti o problemi aperti, attività che Jev non svolge.
- Tratta i numeri come un segnale da verificare su esempi reali del tuo dominio.
Non allucina non significa che ha sempre ragione
TypeSafe afferma che Jev non allucina perché non può inventare un campo o restituire un valore fuori dallo schema. Questa è una garanzia sulla forma dell'output, non sulla correttezza della decisione. Se le opzioni sono billing e technical, Jev restituirà una delle due nel formato previsto, ma può ancora scegliere quella sbagliata.
- Type safety: la risposta appartiene all'insieme consentito.
- Accuratezza: la risposta scelta corrisponde al caso reale.
- Calibrazione: una probabilità dell'80% dovrebbe essere corretta circa otto volte su dieci su casi simili.
- La confidence di una Choice e la probabilità assegnata a un'opzione non sono la stessa misura.
- Sono proprietà diverse e vanno misurate separatamente sul proprio dataset.
Jev non è solo JSON vincolato
Anche gli LLM possono produrre JSON conforme a uno schema tramite structured output o constrained decoding. La differenza dichiarata da TypeSafe è nel lavoro svolto dal modello: Jev non genera la serializzazione un token alla volta, ma valuta in parallelo le alternative definite e restituisce probabilità. Il vantaggio potenziale riguarda quindi latenza, costo e uso dell'incertezza, non la sola validità del JSON.
- Uno structured output LLM resta utile quando devi anche generare testo o spiegazioni.
- Jev è più mirato quando la decisione finale appartiene a un insieme chiuso.
- Le informazioni pubbliche non bastano ancora per verificare in modo indipendente tutti i dettagli dell'architettura e del training RLCD.
Quando usare Jev
Jev ha senso quando il software deve ripetere giudizi semantici con alternative note. Il caso ideale non è una domanda aperta, ma un punto del workflow in cui una regola tradizionale è troppo rigida e una chiamata a un grande modello generativo sarebbe lenta o costosa.
- Classificazione e smistamento di ticket, email, documenti o richieste.
- Punteggi di qualità, rischio, urgenza o conformità a una rubrica.
- Routing fra modelli, strumenti, code operative o livelli di revisione.
- Guardrail su chiamate agli strumenti, output e tracce di agenti.
- Valutazioni ripetute dentro pipeline RAG, supporto o moderazione.
Quando serve ancora un LLM
Scegli un LLM quando non conosci in anticipo la forma della risposta o vuoi che il modello produca qualcosa di nuovo. Jev non scrive email, non genera codice, non riassume documenti e non spiega il proprio ragionamento. Può affiancare un LLM come router o revisore, ma non svolgere la parte generativa al suo posto.
- Conversazioni e assistenza con risposte formulate per l'utente.
- Scrittura, sintesi, traduzione e generazione di codice.
- Ricerca o analisi in cui le possibili conclusioni non sono note prima.
- Problemi che richiedono più passaggi di ragionamento e uso di strumenti.
- Decisioni che devono essere motivate con una spiegazione auditabile.
I limiti dichiarati da TypeSafe
La documentazione di Jev 1.13 descrive limiti importanti. Il modello può leggere le istruzioni in modo troppo letterale, non è affidabile per calcoli o confronti fra date, perde accuratezza quando lo stato contiene dettagli irrilevanti e può essere influenzato da contenuti avversariali. Anche domande logicamente equivalenti possono produrre probabilità non coerenti fra loro.
- Esegui matematica, conteggi, date e regole esatte nel codice.
- Riduci il contesto ai dati necessari per quella decisione.
- Aggiungi un'opzione come non determinabile quando nessuna risposta è adeguata.
- Non trasferire la stessa soglia fra tipi di domanda diversi senza ricalibrarla.
- Testa prompt injection e casi limite prima di automatizzare azioni sensibili.
Come verificare se conviene nel tuo workflow
Non partire dai moltiplicatori del lancio. Prepara esempi reali con etichette affidabili, confronta Jev con l'LLM e con il codice che useresti davvero, poi misura costo, latenza e qualità della decisione. La soglia operativa deve dipendere dal danno di un errore, non dalla confidence mostrata in un singolo caso.
- Separa un set di calibrazione da un set di test finale.
- Misura precisione e richiamo per ogni classe, non solo accuratezza media.
- Controlla se probabilità dell'80% corrispondono davvero a circa l'80% di esiti corretti.
- Definisci una fascia incerta da inviare a un LLM o a una persona.
- Mantieni regole deterministiche e autorizzazioni fuori dal modello.
- Rivaluta soglie e prestazioni quando cambia la versione di Jev o il tipo di input.
La regola pratica
Usa Jev per decisioni frequenti con alternative finite, un LLM per generare e ragionare, codice tradizionale per regole esatte e una persona per i casi ad alto impatto. La combinazione più utile è spesso Jev davanti al workflow: gestisce i casi chiari, mentre quelli incerti passano a un modello più capace o alla revisione umana.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Jev è un LLM?
TypeSafe lo presenta come un System One model distinto dagli LLM generativi. Dall'esterno, la differenza verificabile è l'interfaccia: Jev riceve testo ma restituisce decisioni tipizzate e probabilità invece di generare una stringa. I dettagli completi dell'architettura non sono pubblici.
Jev può davvero non allucinare?
Può garantire che l'output rispetti lo schema e contenga solo valori consentiti. Non garantisce che la scelta sia corretta: una classificazione valida ma assegnata alla categoria sbagliata resta un errore.
Quanto costa Jev?
Al 20 settembre 2026 TypeSafe indica $0,042 per milione di token input e nessun costo misurabile per l'output. Il costo reale dipende anche da volume, retry, revisioni ed eventuali chiamate successive a un LLM.
Jev può sostituire GPT, Claude o Gemini?
Solo nei passaggi che richiedono una decisione fra opzioni note. GPT, Claude e Gemini restano necessari per conversazione, contenuti, codice, sintesi e problemi aperti. Jev può instradare o controllare il loro lavoro.
Qual è la differenza fra Jev e uno structured output LLM?
Entrambi possono rispettare uno schema. Un LLM genera comunque l'output token per token; Jev è progettato per valutare alternative in parallelo e restituire probabilità. Va confrontato sul proprio dataset per capire se il vantaggio di costo e latenza compensa eventuali differenze di accuratezza.
Jev è adatto a decisioni ad alto rischio?
Non come decisore unico. Per pagamenti, salute, sicurezza, accessi o altri casi ad alto impatto servono regole deterministiche, soglie validate, log e revisione umana. La confidence del modello non sostituisce una verifica sul proprio dominio.
Prossime letture