Grok 4.7 conviene? Prezzo e benchmark per il coding
Costa meno di molti modelli frontier ed è addestrato per task lunghi, ma i benchmark xAI mostrano vantaggi e limiti diversi
Entra nell'analisi
Risposta breve
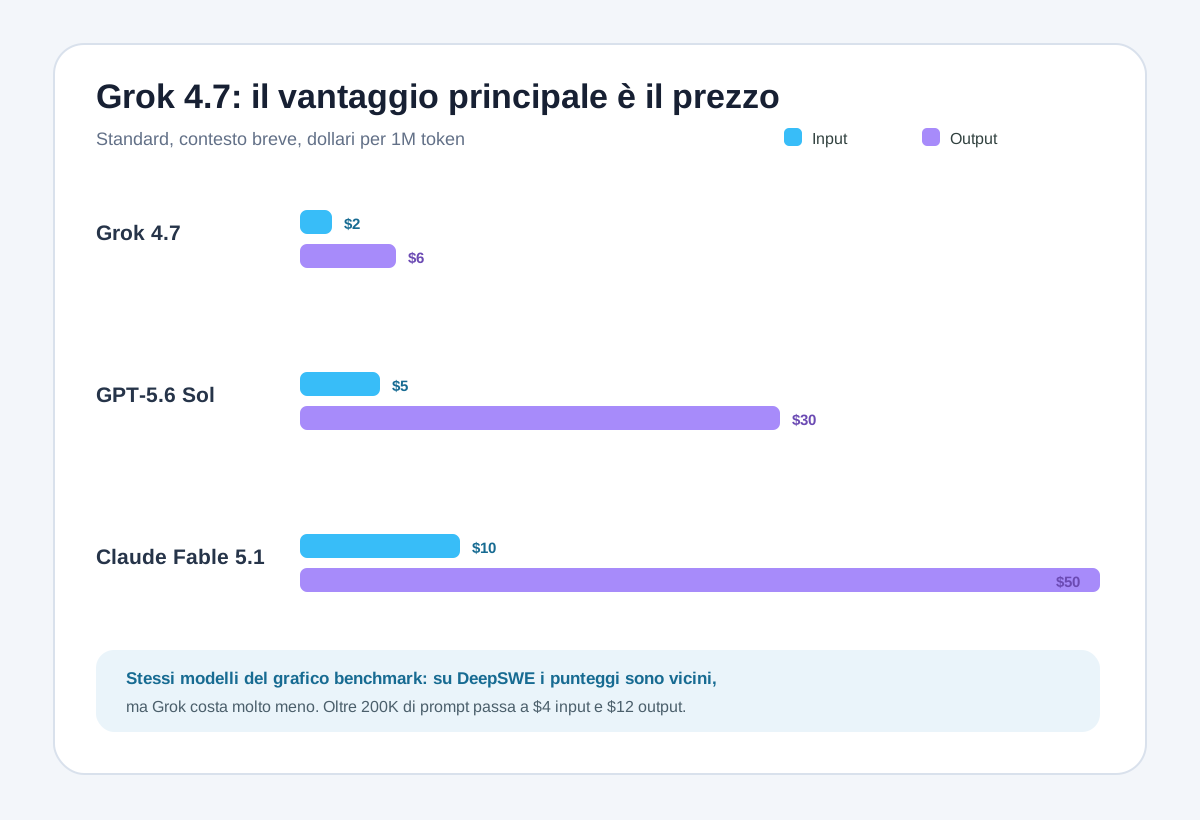
Prova Grok 4.7 se vuoi contenere il costo di coding agentico, documenti e automazioni senza scendere a un modello leggero. Nei benchmark xAI è vicino a GPT-5.6 Sol e Claude Fable 5.1 su DeepSWE, ma costa $2/$6 contro $5/$30 e $10/$50. Su Terminal-Bench resta molto sotto Fable e oltre 200K token il prezzo raddoppia.
- Prezzo base: $2 input, $0,50 cached input e $6 output per 1M token.
- Oltre 200K di prompt: $4 input, $1 cached input e $12 output.
- Contesto da 500K token, input testo e immagini, output testuale.
- È disponibile in API, Grok Build, Cursor, router e piattaforme cloud.
- La variante Fast raddoppia velocità e prezzo ed è limitata a Cursor e Grok Build.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Dato | Come usarlo per scegliere |
|---|---|---|
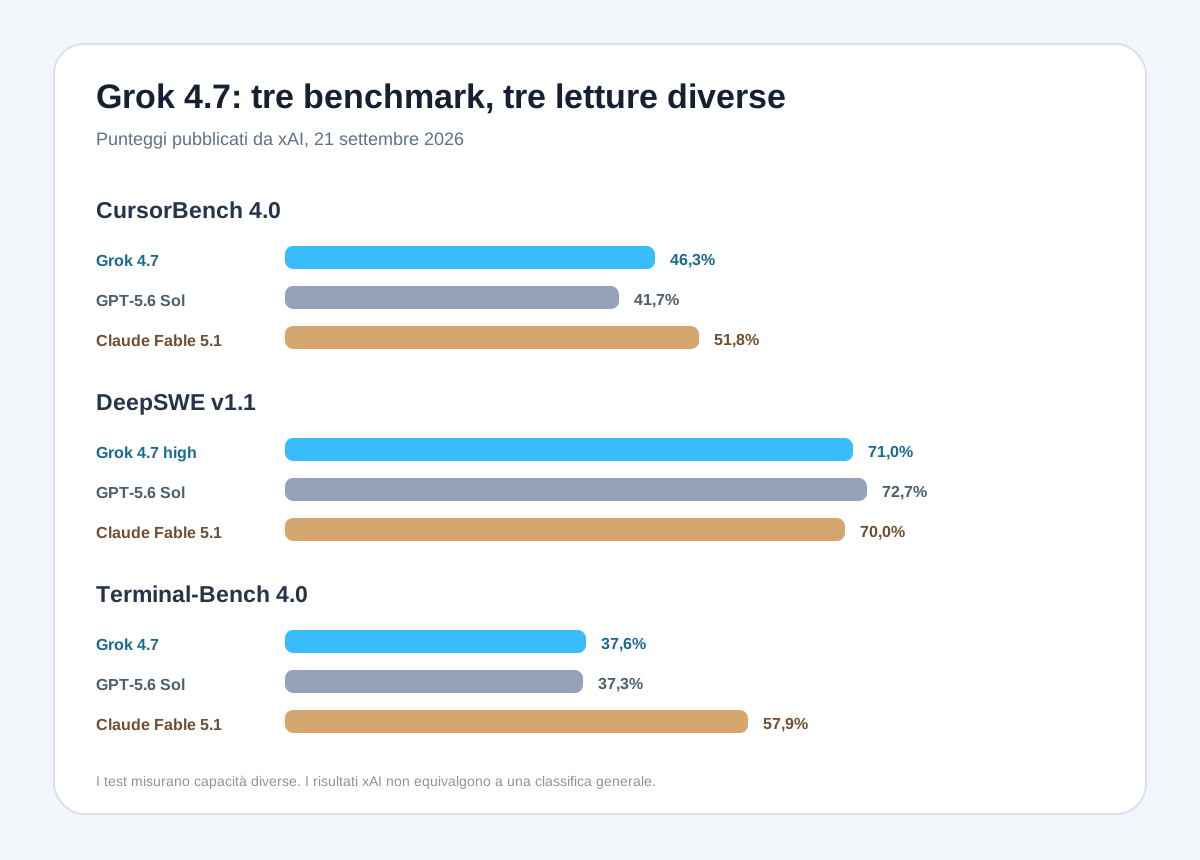
| Coding in Cursor | 46,3% su CursorBench 4.0, contro 41,7% di GPT-5.6 Sol e 51,8% di Fable 5.1 nella tabella xAI. | Il risultato giustifica una prova dentro Cursor, ma Claude Fable 5.1 resta avanti e il benchmark non misura tutti i repository o gli stili di lavoro. |
| Task software complessi | 71,0% su DeepSWE v1.1 ad high effort. | Il punteggio è vicino a GPT-5.6 Sol al 72,7% e Claude Fable 5.1 al 70,0%. Con distanze così piccole, costo e harness possono contare più del punteggio. |
| Terminale per molte ore | 37,6% su Terminal-Bench 4.0. | Quasi eguaglia GPT-5.6 Sol al 37,3%, ma resta molto sotto Claude Fable 5.1 al 57,9%. Per agenti lunghi serve un pilot prima di cambiare modello. |
| Prezzo | Grok: $2/$6 sotto 200K di prompt. GPT-5.6 Sol: $5/$30. Fable 5.1: $10/$50. | Grok costa meno nella stessa coorte dei benchmark. Nei contesti lunghi il vantaggio si riduce e va confrontato con cache, output e retry. |
| Ecosistema | API xAI, Grok Build, Cursor, OpenRouter, Vercel e Cloudflare. | Ha senso se puoi provarlo senza cambiare tutto lo stack. Grok Build è il percorso più diretto per un test da terminale. |
Applicazione
Costo breve e contesto lungo
Le stime usano il listino xAI verificato il 23 settembre 2026. Non includono web search, strumenti esterni, retry o maggiorazione del 10% per l'endpoint regionale statunitense.
Task sotto soglia
100K input · 20K output
- Scenario
- Grok 4.7: $0,32
- Costo indicativo
- GPT-5.6 Sol: $1,10
Su DeepSWE Grok segna 71,0% e GPT-5.6 Sol 72,7%. In questo carico Grok costa circa il 71% in meno.
Task oltre 200K
250K input · 20K output
- Scenario
- Grok 4.7: $1,24
- Costo indicativo
- GPT-5.6 Sol: $1,85
Grok entra nella fascia $4/$12 ma resta meno caro di GPT-5.6 Sol in questo esempio. Il divario è molto più piccolo rispetto al contesto breve.
Confronto con Fable 5.1
100K input · 20K output
- Scenario
- Grok 4.7: $0,32
- Costo indicativo
- Fable 5.1: $2,00
Su DeepSWE Grok e Fable sono vicini, ma Grok costa l'84% in meno in questo carico. Su Terminal-Bench Fable resta invece molto avanti.
Dove Grok 4.7 è cambiato
xAI descrive Grok 4.7 come un modello più grande di Grok 4.6, addestrato più a lungo su task che richiedono ore. L'obiettivo è migliorare verifica del lavoro, gestione del contesto e comportamento dentro il Grok Bot harness. Il listino base resta quello di Grok 4.6.
- Nuovo modello base e reinforcement learning più lungo.
- Reasoning effort low, medium, high o xhigh.
- Contesto da 500K token e nessun limite testuale di output dichiarato.
- Prompt cache key consigliata per mantenere le richieste sullo stesso server.
I benchmark non indicano un vincitore unico
Nella tabella xAI, Grok 4.7 supera il precedente GPT-5.6 Sol su CursorBench e lo avvicina su DeepSWE e Terminal-Bench. Claude Fable 5.1 resta molto avanti sul lavoro prolungato da terminale, mentre Grok ottiene risultati più forti in alcune prove legali ed elettriche. Questi dati non confrontano Grok con il nuovo GPT-6 Sol.
- CursorBench favorisce il caso d'uso dentro l'editor.
- DeepSWE mostra differenze piccole tra Grok, Sol e Fable.
- Terminal-Bench segnala un limite per gli agenti più lunghi.
- I risultati sono del vendor e vanno replicati sul proprio harness.
Il limite economico oltre 200K token
Il prezzo $2/$6 vale sotto 200K token di prompt. Superata la soglia, xAI addebita $4 input, $1 cached input e $12 output per milione di token. GPT-5.6 Sol, lo stesso modello presente nei benchmark xAI, costa $5/$30 nel contesto breve: tra 200K e 272K Grok resta meno caro, ma il vantaggio si restringe.
- Controlla il prompt effettivo dopo allegati e tool result.
- Usa compaction nei loop lunghi.
- Imposta una cache key stabile per evitare input non memorizzato.
- Calcola il costo sull'intera richiesta, non soltanto sui token oltre soglia.
Quando provarlo in Cursor o Grok Build
Grok 4.7 è disponibile direttamente in Cursor e diventa il modello predefinito di Grok Build. Questi ambienti permettono di testarlo senza costruire un harness da zero. Usa issue reali con test e criteri di riuscita, poi confronta il risultato con il modello che già usi.
- In Cursor misura qualità del diff, numero di iterazioni e costo.
- In Grok Build controlla piani, comandi, test e rollback.
- Via API registra token, cache hit e tempo totale del task.
- Non valutare il modello su una sola demo o su codice generato senza test.
Grok 4.7, GPT-5.6 Sol o Fable 5.1
Grok 4.7 è il candidato economico della coorte mostrata nei benchmark. GPT-5.6 Sol resta vicino su DeepSWE e Terminal-Bench ma costa di più; Fable 5.1 costa molto di più e guida Terminal-Bench. La scelta dipende quindi dal tipo di task, non da un solo rapporto prezzo-punteggio.
- Grok 4.7: prova prioritaria per prezzo e integrazione con Cursor o Grok Build.
- GPT-5.6 Sol: confronto OpenAI usato nei benchmark xAI.
- Fable 5.1: candidato premium quando il lavoro prolungato da terminale conta più del listino.
- Usa un router solo se policy dati, logging e fallback sono accettabili.
Come fare un confronto che serva davvero
Prepara almeno dieci task rappresentativi, blocca strumenti e criteri di successo e ripeti le prove critiche. Registra non soltanto il costo della richiesta, ma anche task completati, test falliti, retry e minuti di review. Promuovi Grok solo nei passaggi in cui il vantaggio resta stabile.
- Separa coding, documenti e automazioni invece di usare un punteggio unico.
- Mantieni uguali contesto, timeout e permessi.
- Fai giudicare il risultato da test o persone che non sanno quale modello lo ha prodotto.
- Prevedi un fallback per i task con costo di errore alto.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Quanto costa Grok 4.7?
Sotto 200K token di prompt costa $2 input, $0,50 cached input e $6 output per 1M token. Oltre 200K, l'intera richiesta passa a $4 input, $1 cached input e $12 output.
Grok 4.7 è migliore di GPT-5.6 Sol?
Non in assoluto. Nei benchmark xAI Grok è avanti su CursorBench, vicino su DeepSWE e quasi pari su Terminal-Bench. Costa meno sia nel contesto breve sia nell'esempio tra 200K e 272K token, ma il risultato va verificato sul proprio harness.
Grok 4.7 è disponibile in Grok Build?
Sì. È il modello predefinito di Grok Build ed è disponibile anche in Cursor, API xAI, router modello e piattaforme cloud. La variante Fast è limitata a Cursor e Grok Build.
Grok 4.7 supporta immagini?
Accetta testo e immagini in input e produce testo. Supporta function calling, web search, ricerca su X e code execution tramite gli strumenti documentati da xAI.
Conviene sostituire subito Grok 4.5?
Per nuovi test sì, perché xAI posiziona 4.7 come modello più capace allo stesso prezzo base. Nei workflow esistenti confronta prima qualità, consumo token, cache e failure mode e mantieni un rollback.
Prossime letture