DeepSeek V4.1 Flash costa fino al 97% meno: può battere GPT e Claude?
Sul prezzo API per token costa fino al 97% meno. Nei benchmark guida alcune automazioni, non i compiti più difficili
Entra nell'analisi
Il verdetto in breve
DeepSeek V4.1 Flash non è il nuovo modello più intelligente in assoluto: Artificial Analysis gli assegna 40 punti, contro 47-53 dei principali modelli di frontiera. Ma su automazioni e alcuni test di coding arriva vicino o davanti a GPT e Claude, con prezzi API per token oltre il 90% più bassi e fino al 97% in meno sull'input. È una scelta forte per lavori verificabili e ad alto volume, non un sostituto universale.
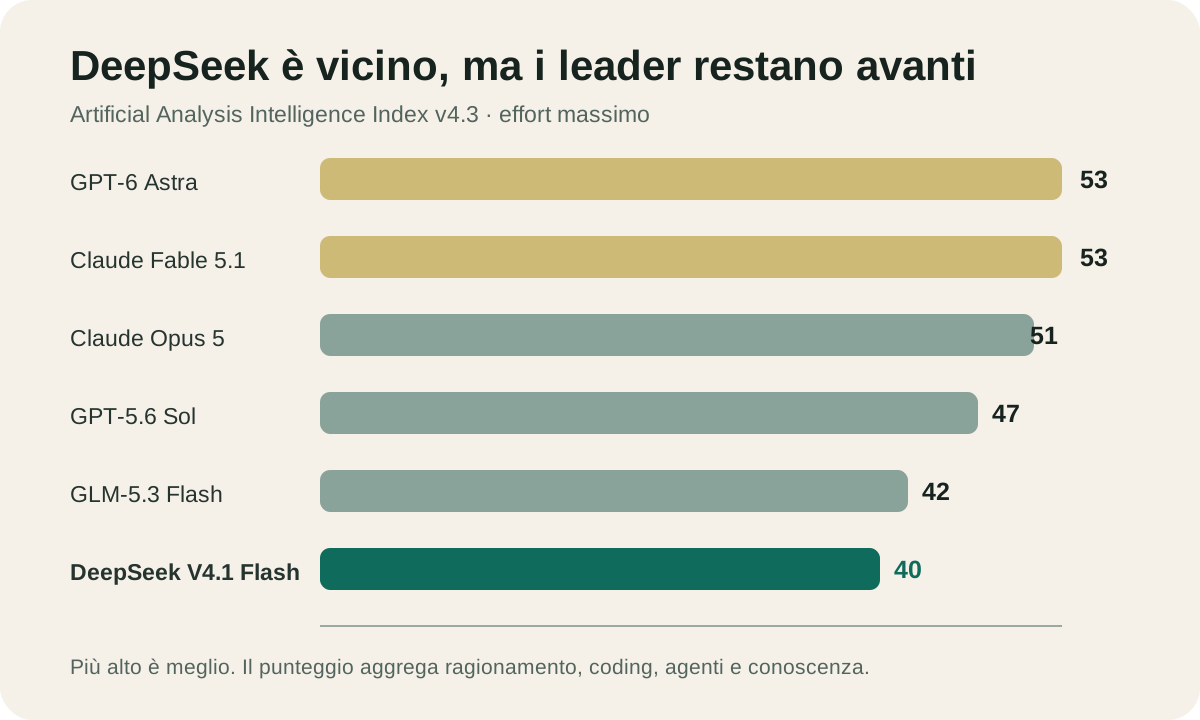
- Artificial Analysis: 40 punti, sotto GPT-6 Astra e Claude Fable 5.1 a 53.
- AutomationBench-AA: DeepSeek arriva al 69%, leggermente sopra Astra al 68%.
- Nei dati DeepSeek supera Opus 5 e GPT-5.6 Sol su Terminal-Bench 2.1 e DeepSWE v1.1.
- Su Terminal-Bench 4.0 e Humanity's Last Exam resta nettamente dietro ai modelli di frontiera.
- Il prezzo per token è eccezionale, ma l'elevato numero di token prodotti può ridurre il risparmio reale.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | DeepSeek V4.1 Flash | GPT e Claude |
|---|---|---|
| Intelligenza complessiva, test indipendente | 40 punti nell'Artificial Analysis Intelligence Index v4.3. | GPT-6 Astra e Claude Fable 5.1 arrivano a 53, Opus 5 a 51 e GPT-5.6 Sol a 47. |
| Automazioni, test indipendente | 69% su AutomationBench-AA, il risultato più sorprendente della valutazione esterna. | GPT-6 Astra è al 68%. DeepSeek è leggermente avanti in questa prova, non nel punteggio complessivo. |
| Coding agentico, dati DeepSeek | 74,2 su DeepSWE v1.1 e 90,6 su Terminal-Bench 2.1. | Opus 5 ottiene 74,0 e 89,1; GPT-5.6 Sol 73,0 e 88,8. Le differenze sono piccole e dipendono anche dall'harness. |
| Task lunghi e difficili, dati DeepSeek | 31,2 su Terminal-Bench 4.0 e 64,0 su NL2Repo-Bench. | Opus 5 sale a 51,8 e 75,3; GPT-5.6 Sol arriva a 39,9 su Terminal-Bench 4.0. |
| Ragionamento senza strumenti, dati DeepSeek | 90,9 su GPQA Diamond e 36,8 su Humanity's Last Exam, 39,1 nel sottoinsieme solo testo. | Sol raggiunge 94,1 e 44,5; Opus 5 arriva a 93,4 e 56,3. Qui i modelli di frontiera conservano un vantaggio netto. |
| Prezzo API di picco | $0,30 input e $1,20 output per 1M token. | Sol costa $4/$20, Opus 5 $5/$25, Astra e Fable 5.1 $10/$50 per 1M token. |
Applicazione
Quanto cambia davvero il conto
Il prezzo per token è il vantaggio più evidente, ma non basta da solo. Un modello molto verboso o che richiede più tentativi può costare più del previsto. Per questo conviene guardare sia il listino sia il costo per task misurato da Artificial Analysis.
Un task con molto contesto
1M input senza cache · 100K output
- DeepSeek V4.1 Flash
- DeepSeek: $0,42
- Modelli di frontiera
- Sol $6, Opus $7,50, Astra e Fable $15
A parità di token il risparmio è circa del 93-97%. Nuovi tentativi, strumenti e revisione possono cambiare il risultato.
Costo nel benchmark indipendente
Artificial Analysis Index · Media ponderata per task
- DeepSeek V4.1 Flash
- DeepSeek: $0,27
- Modelli di frontiera
- GPT-5.6 Luna max: $0,18
I token economici non garantiscono il task più economico: DeepSeek produce molto più output durante i test.
Lo stesso carico fuori picco
1M input senza cache · 100K output
- DeepSeek V4.1 Flash
- DeepSeek: $0,21
- Modelli di frontiera
- Tariffa dimezzata
Per lavori programmabili, le fasce off-peak rendono il divario ancora più ampio senza cambiare modello.
Il verdetto: forte, ma non è il nuovo numero uno
Il risultato indipendente più utile è quello di Artificial Analysis: il suo Intelligence Index aggrega ragionamento, coding, uso di strumenti e conoscenza. V4.1 Flash ottiene 40 punti. È sopra GPT-5.6 Luna, fermo a 38, ma sotto GLM-5.3 Flash a 42 e lontano dai 47-53 punti dei modelli di frontiera più forti. DeepSeek ha quindi costruito un modello molto competitivo per il prezzo, non un vincitore assoluto.
- GPT-6 Astra e Claude Fable 5.1: 53 punti.
- Claude Opus 5: 51 punti.
- GPT-5.6 Sol: 47 punti.
- GLM-5.3 Flash: 42 punti; DeepSeek V4.1 Flash: 40.
Dove DeepSeek sorprende davvero
Il dato più interessante non arriva dal materiale promozionale di DeepSeek. Nel test indipendente AutomationBench-AA, che misura attività operative in applicazioni aziendali, V4.1 Flash raggiunge il 69% e supera di poco GPT-6 Astra al 68%. È un segnale concreto: nei flussi con strumenti e passaggi verificabili il modello economico può giocarsela con i migliori.
- Artificial Analysis misura DeepSeek con effort massimo.
- Il vantaggio su Astra è di un punto, quindi non basta per proclamare un vincitore generale.
- Automazione e coding sono i terreni in cui V4.1 Flash appare più competitivo.
DeepSeek è davanti in due test di coding
Nella tabella pubblicata dal produttore, V4.1 Flash supera GPT-5.6 Sol e Claude Opus 5 su Terminal-Bench 2.1 e DeepSWE v1.1. I distacchi sono però ridotti: appena 0,2 punti da Opus su DeepSWE e 1,5 su Terminal-Bench 2.1. Inoltre l'harness cambia molto il risultato, quindi questi numeri dimostrano competitività, non superiorità certa.
- DeepSWE v1.1: DeepSeek 74,2, Opus 74,0, Sol 73,0.
- Terminal-Bench 2.1: DeepSeek 90,6, Opus 89,1, Sol 88,8.
- AutomationBench pubblicato da DeepSeek: 54,8 contro 50,3 di Opus e 45,8 di Sol.
- Sono risultati del vendor e vanno distinti dai test indipendenti.
Dove GPT e Claude restano nettamente avanti
Quando i task diventano più lunghi o richiedono ragionamento senza strumenti, la distanza riappare. Su Terminal-Bench 4.0 Opus 5 ottiene 51,8 contro 31,2 di DeepSeek. Su Humanity's Last Exam senza strumenti Opus arriva a 56,3 e Sol a 44,5, mentre V4.1 Flash si ferma a 36,8. Per problemi difficili e poco verificabili, il prezzo più alto può ancora comprare un margine utile.
- Terminal-Bench 4.0: DeepSeek 31,2, Sol 39,9, Opus 51,8.
- NL2Repo-Bench: DeepSeek 64,0 contro 75,3 di Opus.
- GPQA Diamond: DeepSeek 90,9, Opus 93,4, Sol 94,1.
- Il profilo è competitivo ma irregolare: dipende molto dal tipo di lavoro.
Il prezzo è così basso da cambiare la decisione
Nelle ore di picco DeepSeek costa $0,30 per 1M token input senza cache e $1,20 per l'output. GPT-5.6 Sol costa $4/$20, Opus 5 $5/$25, mentre Astra e Fable 5.1 arrivano a $10/$50. Il risparmio per token supera il 90% e arriva al 97% sull'input rispetto ai modelli più costosi. Fuori picco DeepSeek dimezza ancora il listino.
- Un task da 1M input e 100K output costa $0,42 con DeepSeek al picco.
- Lo stesso volume costa $6 con Sol, $7,50 con Opus e $15 con Astra o Fable.
- Con input già in cache, DeepSeek scende a $0,006 per milione di token nelle ore di picco.
- Il risparmio conta soprattutto su automazioni ripetute e grandi volumi.
Il limite nascosto: DeepSeek usa molti più token
Artificial Analysis rileva circa 89.000 token di output per task nel proprio indice, contro 41.000 di GPT-5.6 Luna max. Per questo DeepSeek costa $0,27 per task nel test, mentre Luna si ferma a $0,18 nonostante un punteggio inferiore. È il promemoria più importante: confronta il costo del risultato, non solo il prezzo scritto nel listino.
- Un modello verboso può consumare parte del vantaggio per token.
- Retry e correzioni manuali incidono più del listino nei task difficili.
- Misura sempre costo, tempo e qualità sullo stesso lavoro.
Cosa significa se non sei uno sviluppatore
Se usi l'AI per scrivere, riassumere, analizzare documenti o fare ricerche, i benchmark di terminale non bastano per cambiare strumento. V4.1 Flash merita una prova quando è disponibile nell'app o nel servizio che usi, soprattutto per automazioni e grandi volumi. ChatGPT, Claude e Gemini restano più semplici se contano ecosistema, integrazioni e qualità costante su compiti diversi.
- Provalo su tre attività reali, non su domande preparate per impressionare.
- Confronta accuratezza, chiarezza e numero di correzioni necessarie.
- Non inviare dati sensibili prima di aver verificato termini e trattamento dei dati.
- Il modello più economico è utile solo se produce un risultato che puoi usare.
La scelta pratica: quando usare DeepSeek V4.1
Scegli V4.1 Flash per coding, automazioni e carichi ripetuti quando puoi controllare l'output. Mantieni un modello di frontiera per i task più difficili, ambigui o costosi da correggere. Una strategia sensata è usare DeepSeek come prima linea economica e passare a GPT o Claude quando il risultato fallisce i controlli.
- DeepSeek: prima scelta per volume alto, coding verificabile e budget ridotto.
- GPT o Claude: escalation per ragionamento difficile, task lunghi e risultati poco verificabili.
- Gemini: resta interessante se lavori già nell'ecosistema Google o ti serve un modello Flash economico.
- Valuta il costo per task accettato, non il numero di benchmark vinti.
E il confronto con V4 Pro? È ormai secondario
DeepSeek sostiene che V4.1 Flash superi V4 Pro su prestazioni, velocità e costo, ma la propria pagina prezzi continua a offrire V4 Pro su richiesta degli utenti. Per chi usa già l'API, il nuovo Flash è il candidato naturale da testare. Per tutti gli altri, la domanda più utile resta il confronto con i modelli che dominano ChatGPT, Claude e gli altri servizi principali.
- V4.1 Flash aggiunge input visivo e un limite di 2.500 richieste concorrenti.
- V4 Pro resta elencato a un prezzo molto più alto.
- Il contesto dichiarato è 1M token, con output massimo di 384K.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
DeepSeek V4.1 Flash batte GPT-6 Astra?
Non nel confronto complessivo. Artificial Analysis assegna 40 punti a DeepSeek e 53 ad Astra. DeepSeek supera però Astra di poco su AutomationBench-AA, 69% contro 68%, quindi può essere competitivo nelle automazioni con strumenti.
DeepSeek V4.1 Flash batte Claude Opus 5?
Solo in alcuni benchmark pubblicati da DeepSeek, tra cui DeepSWE v1.1 e Terminal-Bench 2.1. Opus 5 resta molto avanti su Terminal-Bench 4.0, NL2Repo-Bench e Humanity's Last Exam senza strumenti.
Quanto costa rispetto a GPT e Claude?
Al picco DeepSeek costa $0,30 input e $1,20 output per 1M token. GPT-5.6 Sol costa $4/$20, Opus 5 $5/$25, Astra e Fable 5.1 $10/$50. Il risparmio supera il 90% e arriva al 97% sull'input rispetto ai modelli più costosi.
DeepSeek V4.1 Flash è davvero un modello di frontiera?
È vicino ai modelli migliori in alcuni test agentici e di coding, ma non nel risultato aggregato indipendente. La definizione più onesta è modello molto competitivo per prezzo, con capacità vicine ai leader nei lavori giusti.
Conviene usarlo al posto di ChatGPT o Claude?
Conviene provarlo per coding, automazioni e grandi volumi verificabili. ChatGPT e Claude restano più adatti quando servono un ecosistema maturo, prestazioni più uniformi o risultati difficili da controllare.
Prossime letture