Claude Sonnet 5.5 vs Opus 5.5
Sonnet 5.5 costa la metà di Opus 5.5 e nei test Anthropic gli resta vicino: ecco quando basta e quando conviene salire a Opus
Entra nell'analisi
Risposta breve
Parti da Sonnet 5.5 per bug fix, feature ben definite, documenti e automazioni frequenti: costa $2/$10 per milione di token contro $4/$20 di Opus 5.5 e nei test Anthropic gli resta vicino. Passa a Opus 5.5 quando il compito è lungo, poco specificato o costoso da correggere: se Sonnet richiede più tentativi, il costo per task si ribalta.
- Sonnet 5.5: $2 input, $10 output e $0,20 cache read per 1M token.
- Opus 5.5: $4 input, $20 output e $0,20 cache read per 1M token.
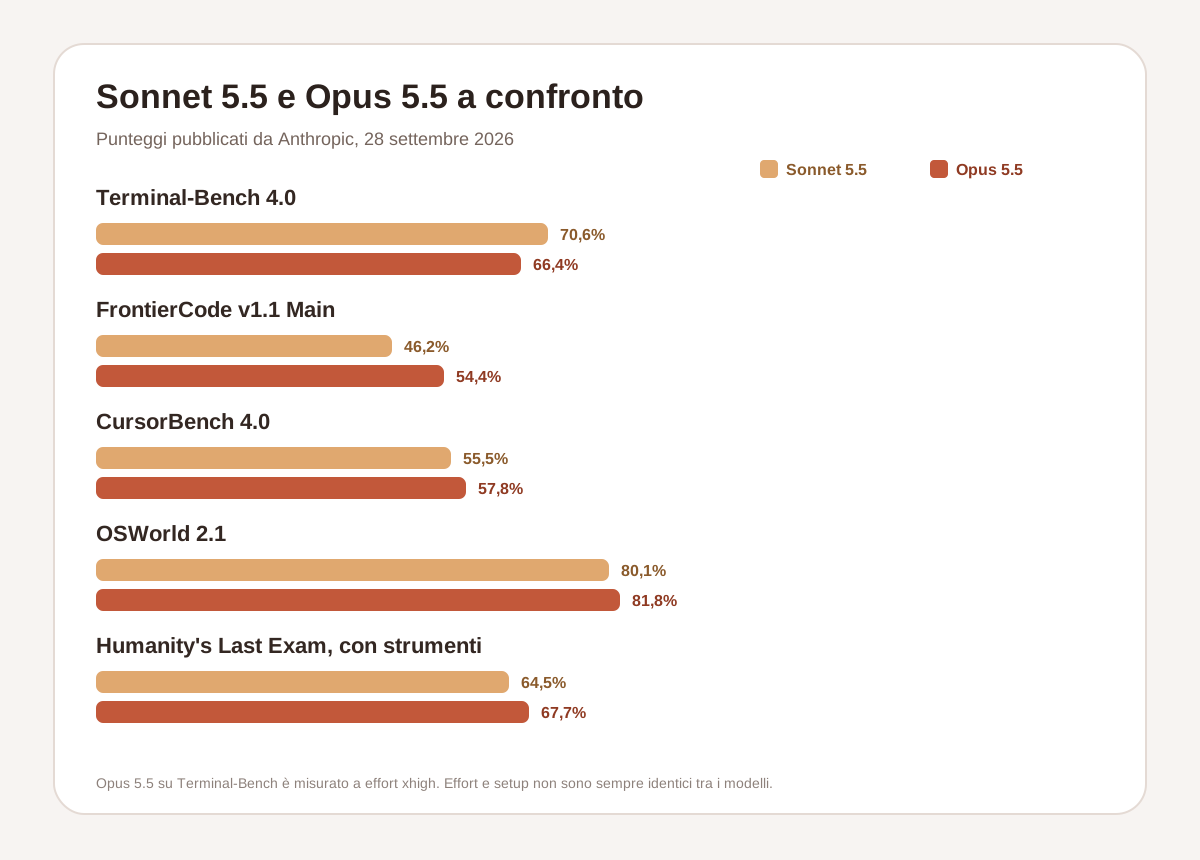
- Terminal-Bench 4.0: Sonnet 5.5 al 70,6%, Opus 5.5 al 66,4% nei dati Anthropic.
- FrontierCode, che misura codice pronto da unire: Opus 5.5 al 54,4%, Sonnet 5.5 al 46,2%.
- Sul piano Free di Claude trovi Sonnet ma non Opus; Pro, Max e Team includono entrambi.
Evidenze
Dati e benchmark citati
Differenze
Il confronto che orienta la scelta
| Criterio | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Prezzo API | $2 input, $10 output, $0,20 cache read, $2,50 cache write a 5 minuti per 1M token. | $4 input, $20 output, $0,20 cache read, $5 cache write a 5 minuti per 1M token. |
| Punto di forza dichiarato | Task ben definiti di tutti i giorni, bug fix, documenti, slide e fogli di calcolo. | Lavoro complesso e aperto che richiede giudizio prolungato, agenti lunghi, knowledge work. |
| Coding agentico | 70,6% su Terminal-Bench 4.0, 46,2% su FrontierCode, 55,5% su CursorBench 4.0. | 66,4% su Terminal-Bench 4.0 a xhigh, 54,4% su FrontierCode, 57,8% su CursorBench 4.0. |
| Knowledge work | 1844 Elo su GDPval-AA v2.1. | 1846 Elo su GDPval-AA v2.1: in pratica pari. |
| Velocità e thinking | Latenza indicata come veloce. Thinking adattivo attivo di default, disattivabile prima della risposta con `between_tools`. | Latenza indicata come moderata. Thinking adattivo sempre attivo, non disattivabile. |
| Contesto e output | 1M token di contesto, 128K di output. | 1M token di contesto, 128K di output. |
| Dove lo trovi | Claude Free, Pro, Max, Team ed Enterprise, Claude Code, API e cloud principali. In GitHub Copilot da Pro in su. | Claude Pro, Max, Team ed Enterprise, Claude Code, API e cloud principali. In GitHub Copilot da Pro+ in su. |
Applicazione
Quanto costa lo stesso task
Le stime usano i listini della Claude API verificati il 29 settembre 2026 e un solo tentativo per task, salvo dove indicato. Non includono strumenti esterni, cache write e maggiorazioni regionali.
Bug fix in un repository
200K input · 20K output
- Scenario
- Sonnet 5.5: $0,60
- Cosa cambia
- Opus 5.5: $1,20
Su task delimitati il rapporto è sempre 1 a 2. Se Sonnet chiude il task al primo tentativo, non c'è motivo di pagare Opus.
Agente con molta cache
5M cache read + 500K input · 100K output
- Scenario
- Sonnet 5.5: $3,00
- Cosa cambia
- Opus 5.5: $5,00
La cache read costa $0,20 su entrambi, quindi nei loop lunghi con contesto riutilizzato il divario scende sotto il doppio.
Refactor che Sonnet sbaglia due volte
300K input a tentativo · 30K output a tentativo
- Scenario
- Sonnet 5.5, 3 tentativi: $2,70
- Cosa cambia
- Opus 5.5, 1 tentativo: $1,80
Il prezzo per token non basta: se un modello richiede retry, costa più del modello caro che chiude al primo colpo. Misura il costo per task accettato.
Che cosa cambia con Sonnet 5.5
Sonnet 5.5 mantiene il listino di Sonnet 5, $2/$10 per milione di token, ma nei dati Anthropic fa un salto netto: su Terminal-Bench 4.0 passa dal 10,3% al 70,6%, su CursorBench dal 34,1% al 55,5%. Anthropic dichiara output oltre il 30% più veloce e fino al 30% di costo in meno per task rispetto a Sonnet 5, grazie a meno token e meno chiamate agli strumenti.
- Model ID sulla Claude API: `claude-sonnet-5-5`.
- Effort predefinito: high sulla Claude API, medium in Claude Code e nelle app Claude.
- Disponibile anche su Amazon Bedrock, Google Cloud e Microsoft Foundry, con supporto alla zero data retention.
- I guadagni di efficienza sono dichiarati da Anthropic: verificali sui tuoi task prima di cambiare budget.
Come leggere i benchmark
Il dato che fa più rumore è Terminal-Bench 4.0, dove Sonnet 5.5 supera Opus 5.5. Va però letto insieme agli altri. FrontierCode premia solo modifiche che si possono unire senza ritocchi e penalizza quelle fuori perimetro: qui Opus resta avanti di oltre 8 punti. Su CursorBench, OSWorld, Humanity's Last Exam e GDPval il distacco a favore di Opus resta entro poco più di tre punti.
- Terminal-Bench misura task complessi in un terminale: Sonnet 5.5 70,6%, Opus 5.5 66,4%.
- FrontierCode misura codice pronto da unire: Opus 5.5 54,4%, Sonnet 5.5 46,2%.
- OSWorld 2.1 misura l'uso del computer: Opus 5.5 81,8%, Sonnet 5.5 80,1%.
- Sonnet 5.5 a effort max ha fatto peggio che a xhigh su FrontierCode: più effort non significa sempre risultati migliori.
Quando Sonnet 5.5 basta
Sonnet 5.5 è la scelta di partenza quando il compito ha confini chiari e puoi verificare il risultato: un test che passa, un documento da controllare, un'estrazione dati con schema. In questi casi paghi metà prezzo per risultati vicini a Opus e ottieni risposte più rapide, utili quando lavori in modo interattivo.
- Bug fix e feature con requisiti definiti e test automatici.
- Documenti, slide e fogli di calcolo da rifinire.
- Automazioni ad alto volume, anche via Batch API con lo sconto del 50%.
- Sessioni interattive in Claude Code in cui la velocità conta più dell'ultimo punto di qualità.
Quando conviene pagare Opus 5.5
Opus 5.5 vale il doppio del prezzo quando l'errore costa più del modello. Anthropic lo indica per il lavoro aperto che richiede giudizio prolungato e riporta che anche i tester esterni hanno trovato Opus più forte su questo tipo di compito. Il segnale pratico è semplice: se Sonnet ti costringe a rilanciare il task o a riscrivere parti del risultato, Opus diventa più economico per task completato.
- Refactor ampi e modifiche che toccano architettura o più servizi.
- Agenti che lavorano a lungo senza supervisione continua.
- Analisi in cui devi pesare fonti o requisiti in conflitto.
- Codice che deve arrivare in review già pronto da unire.
Come scegliere senza affidarti ai benchmark
Prendi 10-20 task reali che hai già risolto, falli girare con entrambi i modelli allo stesso effort e confronta costo totale, tentativi e tempo speso in review. Imposta Sonnet 5.5 come modello predefinito e passa a Opus 5.5 solo per le categorie di task in cui il test mostra un vantaggio chiaro.
- Misura il costo per task accettato, non il costo per chiamata.
- Confronta anche effort diversi: Sonnet a medium può bastare dove oggi usi Opus.
- Ripeti il test quando cambiano prompt, strumenti o versione del modello.
Cosa controllare prima di migrare da Sonnet 5
Sonnet 5.5 introduce modifiche che rompono alcune integrazioni esistenti. Se usavi Sonnet 5 con thinking disattivato, devi passare all'impostazione `between_tools`. Le richieste che forzano l'uso di uno strumento restituiscono errore, così come valori non predefiniti di temperature, top_p e top_k.
- Sostituisci il thinking disattivato con `between_tools`.
- Usa tool choice `auto` al posto dei tool forzati.
- Rimuovi temperature, top_p e top_k personalizzati.
- Controlla lo streaming: il testo tra una chiamata e l'altra agli strumenti arriva in blocchi thinking.
- Aggiorna il tool di computer use se usi ancora `computer_20251124`.
Sicurezza informatica: un limite da conoscere
Anthropic distribuisce Sonnet 5.5 con salvaguardie per la cybersecurity simili a quelle di Opus 5.5. Trovare e correggere bug nel tuo codice resta possibile, ma le attività di sicurezza considerate a rischio più alto vengono passate in modo visibile a Sonnet 5. Se lavori in penetration testing o ricerca di vulnerabilità, verifica prima che il flusso non venga declassato.
La newsletter di QualeAI
Le novità che meritano il tuo tempo.
Aggiornamenti editoriali su tool, modelli, prezzi e workflow. Solo quando c’è qualcosa di utile da capire.
Prima di chiudere
Domande frequenti
Claude Sonnet 5.5 è migliore di Opus 5.5?
Non in generale. Nei benchmark Anthropic lo supera su Terminal-Bench 4.0, ma resta indietro su FrontierCode, CursorBench, OSWorld e Humanity's Last Exam. È la scelta migliore per rapporto qualità prezzo sui task ben definiti; Opus resta più forte sul lavoro lungo e ambiguo.
Quanto costa Claude Sonnet 5.5?
Sulla Claude API costa $2 per milione di token in input, $10 in output e $0,20 per la cache read. La cache write a 5 minuti costa $2,50. Con la Batch API input e output hanno uno sconto del 50%.
Posso usare Sonnet 5.5 gratis?
Il piano Free di Claude include i modelli Sonnet, con limiti di utilizzo ridotti. Opus e Claude Code richiedono un piano a pagamento, da Pro in su. Via API Sonnet 5.5 si paga a consumo.
Quale modello usare in Claude Code?
Parti da Sonnet 5.5 per il lavoro quotidiano: in Claude Code l'effort predefinito è medium e le risposte sono più rapide. Passa a Opus 5.5 per refactor ampi, sessioni agentiche lunghe o quando Sonnet richiede più tentativi.
Sonnet 5.5 sostituisce Sonnet 5?
Sì, allo stesso prezzo e con risultati molto superiori nei test Anthropic. Prima di cambiare model ID controlla le modifiche su thinking, tool forzati, parametri di campionamento e streaming.
Prossime letture